数据增强最早给人的印象,通常是随机裁剪、翻转、颜色抖动和旋转。它们的目的很直接:在不新增人工标注的前提下,让模型看到同一个样本的更多变体,从而减少过拟合。
但进入视觉语言模型(VLM)和视觉语言动作模型(VLA)之后,“把输入变多”已经不够了。图像和文本要保持语义对齐,视频要保持时间关系,机器人动作还要和环境变化一致。更进一步,真实数据中的安全关键场景往往非常稀有,单靠已有样本的变换和重组仍然不够。
这篇文章按增强对象的变化,梳理一条从像素级视图、模态关系到生成式场景的路线。这里的“数据增强”会使用广义含义:既包括训练前生成新样本,也包括推理时对输入进行动态处理。论文状态和实验数字以文末链接中的公开页面为准。
| 层次 | 代表方法 | 增强对象 | 主要目标 |
|---|---|---|---|
| 像素与视图 | SimCLR | 同一图像的不同视图 | 学习对无关变化更稳定的表示 |
| 推理与模态关系 | VACoT、MIDAS | 视觉视图、模态配对与训练权重 | 补足感知细节,缓解模态偏置 |
| 时空与生成 | VISTA、Cosmos-Drive-Dreams | 视频组合与全新场景 | 扩展时间、分辨率和长尾分布 |
一、SimCLR:先让模型学会“变了还是同一个”
SimCLR 的全名是 A Simple Framework for Contrastive Learning of Visual Representations。这项工作由 Ting Chen 等人完成,发表于 ICML 2020,核心是用对比学习从无标注图像中学习视觉表示。
给定一张图像,SimCLR 独立采样两次增强,得到两个相关视图。两个视图组成正样本对;同一批次中来自其他图像的视图则作为负样本。编码器分别提取表示,投影头把表示映射到对比损失空间,训练目标是拉近正样本、推远负样本。
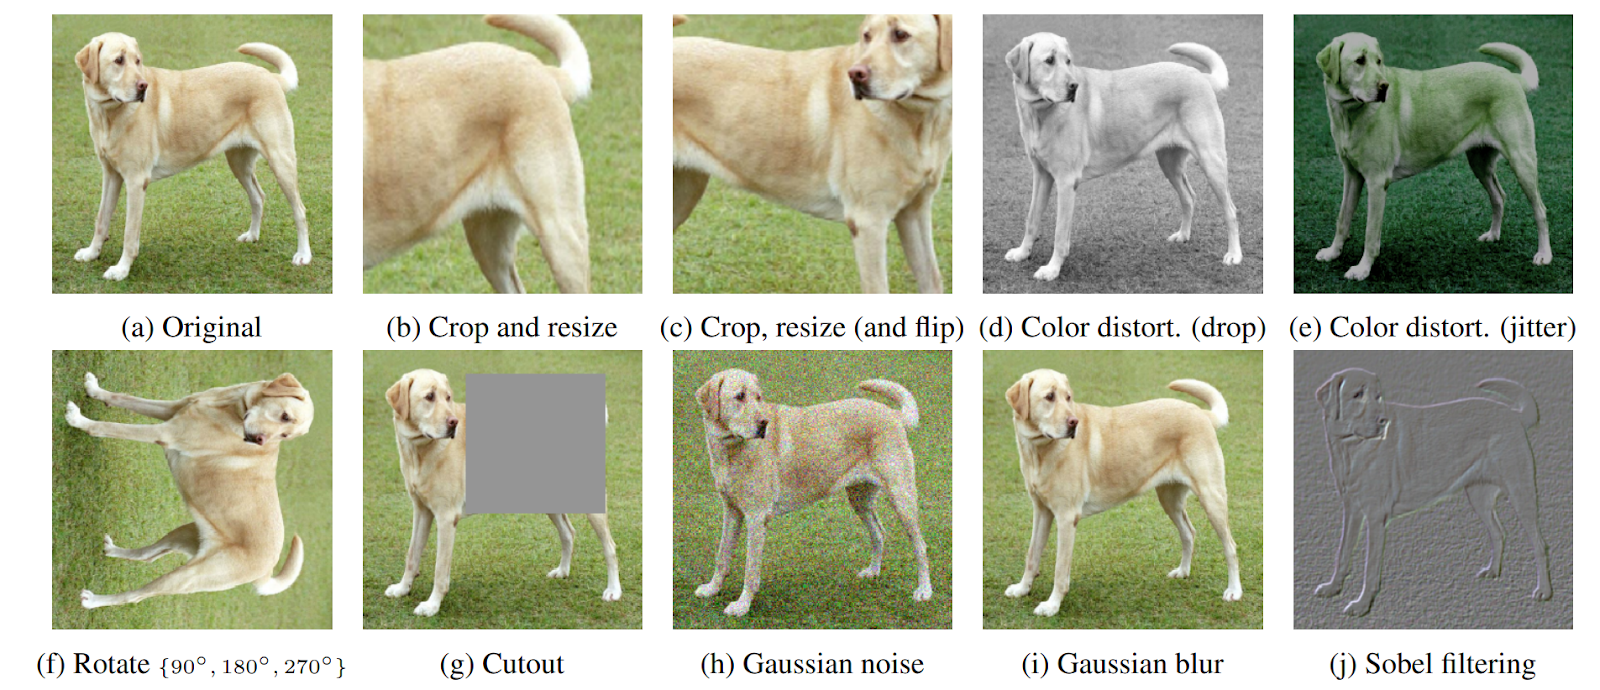
图:常见的裁剪、颜色变换、旋转、遮挡、模糊和边缘检测等增强操作。图片来自 University of Amsterdam Deep Learning Tutorials,原始方法见 SimCLR 论文。
它的训练流程可以概括为:
- 对每张图像应用两次随机增强,得到两个视图;
- 用同一个编码器提取两个视图的表示;
- 使用 NT-Xent 损失,让同图像视图的表示更接近,让不同图像的表示更远。
SimCLR 的重要结论不是“增强越多越好”,而是增强组合定义了模型正在学习的任务。论文的默认策略包括随机裁剪并缩放、随机翻转、颜色变换和高斯模糊;其中裁剪与颜色变换的组合尤其关键。只有裁剪时,模型可能借助局部区域的颜色分布完成匹配,颜色扰动则迫使它更多关注形状和纹理等信息。
因此,SimCLR 的经验可以总结为一句话:增强要改变表面形式,但不能破坏任务真正需要的语义。
二、VLM 需要的不只是“改图”,还要“改得有理由”
在图像分类里,翻转一张猫的图片通常不会改变类别。但在图文任务里,一张“左手拿杯子”的图片水平翻转之后,文字描述可能就不再成立;在视频任务里,打乱时间轴甚至会直接破坏动作顺序。
所以,多模态增强至少要回答两个问题:哪些变化仍然保持标签语义?如果输入被改变,配套的文本、时间戳和动作是否也需要同步更新?
VACoT:把增强放到推理环节
VACoT 的全名是 VACoT: Rethinking Visual Data Augmentation with VLMs。它提出的不是传统意义上把增强样本提前加入训练集,而是让 VLM 在推理时动态决定是否调用视觉增强操作。
模型面对图像和问题时,可以先输出一条操作,例如裁剪主体、放大局部、旋转、去噪或做边缘检测;外部执行器完成操作后,再把增强后的图像重新编码并接回对话上下文,模型继续生成答案。这个过程可以反复进行,直到模型认为当前视图足够回答问题。
VACoT 的关键区别在于,它把视觉增强作为推理时的工具调用。论文在 13 个感知基准上评估了该框架,并构建了 AdvOCR 来测试对抗性文字识别能力。它更接近“测试时增强 + 工具调用”,不能简单等同于把训练数据集扩大了。
这类方法适合处理“模型有能力,但当前图像看不清”的问题,例如小字、低分辨率局部区域和轻微扰动。它的优势是训练成本相对低,代价则是推理链路变长,并且每一次增强调用都可能引入新的错误。
MIDAS:把错配样本变成训练信号
MIDAS 的全名是 Misalignment-based Data Augmentation Strategy for Imbalanced Multimodal Learning。它关注的是多模态学习中的“模态不平衡”:模型可能过度依赖信息更丰富的模态,而忽略另一个模态。
MIDAS 的思路是有意构造语义错配的样本。例如,把一个样本的图像与另一个样本的文本配在一起,让不同模态提供相互冲突的线索。错配样本并不是被直接当作普通噪声丢弃,而是被用来观察模型究竟依赖了哪一种模态,并据此调整训练信号。
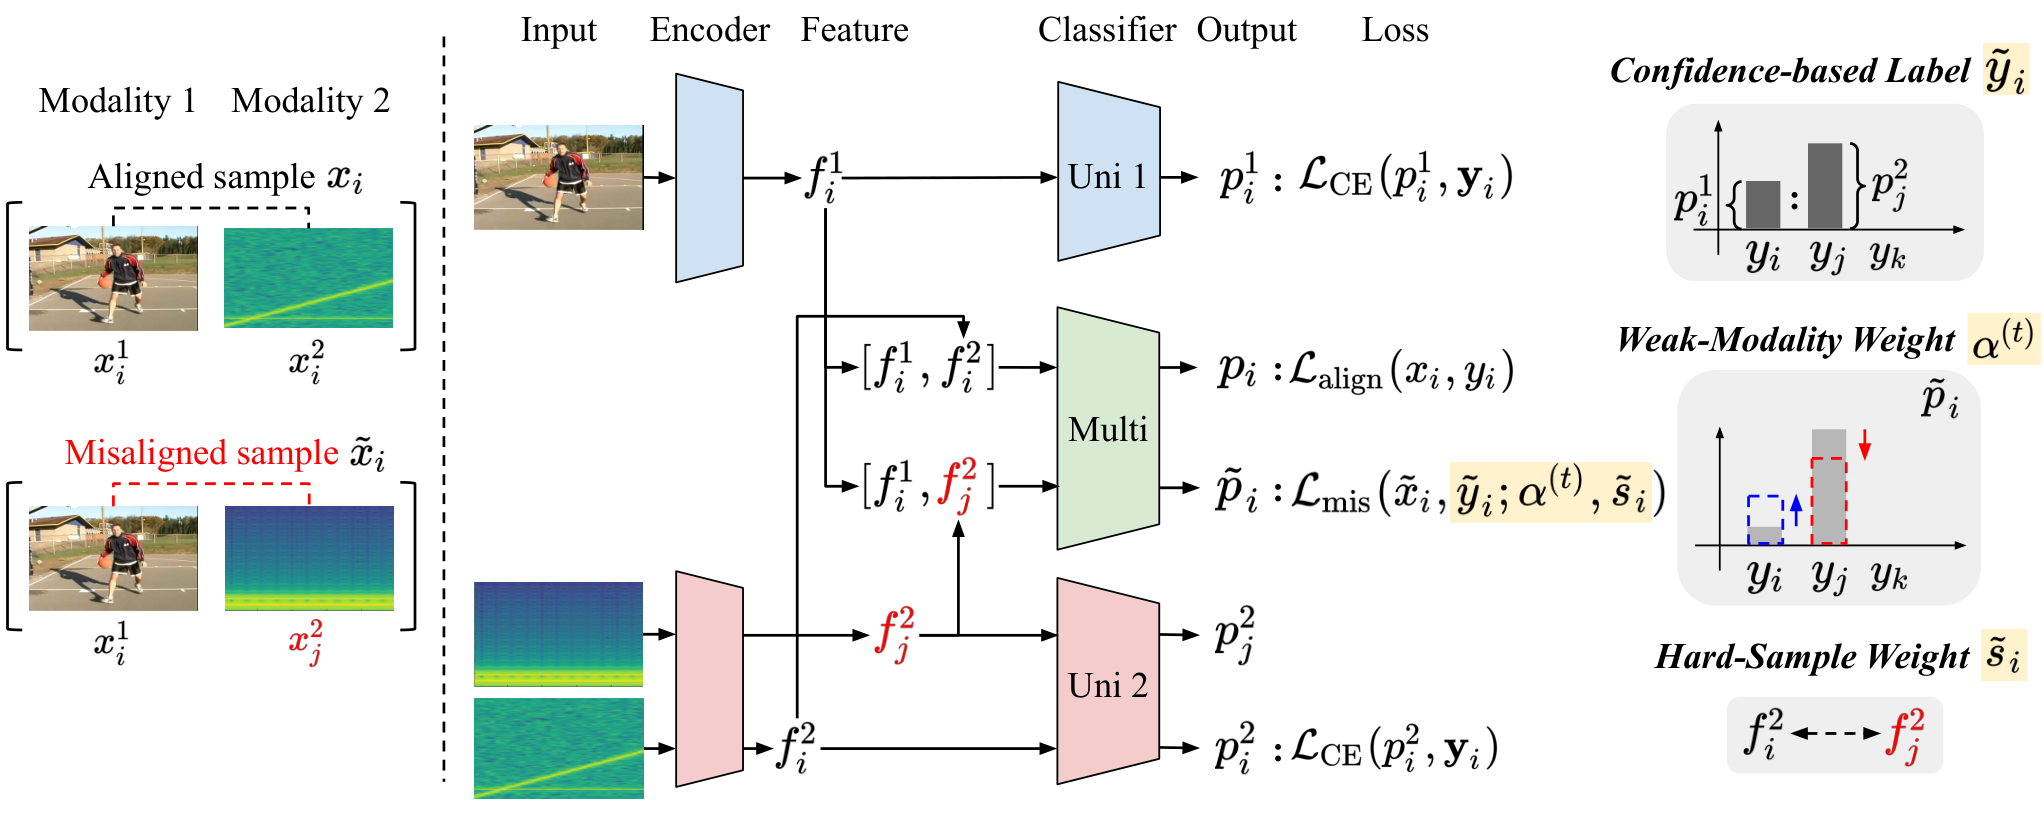
图:MIDAS 的整体框架。图片来自 MIDAS 论文,版权归论文作者所有。
它包含三个关键机制:
- 基于单模态置信度,为错配样本构造软标签;
- 提高弱模态的损失权重,让模型关注平时容易忽略的信息;
- 提高困难错配样本的权重,优先训练那些语义冲突不明显、最容易混淆的样本。
论文报告,在 Kinetics-Sounds 的实验中,普通多模态模型在对齐样本上的准确率为 65.5%,在错配样本上只有 6.3%;这个落差正好暴露了模型对主导模态的依赖。MIDAS 的价值不在于鼓励错误配对本身,而在于把错误配对变成一种诊断和纠偏机制。
三、VISTA:用时空组合补足长视频
图像增强解决的是单帧视图问题,视频还多了一条时间轴。真实数据集中常见的是几秒到几十秒的短片段,但很多问题要求模型理解“先做什么、再做什么,以及跨片段的关系”。
VISTA 的全名是 Enhancing Long-Duration and High-Resolution Video Understanding by Video SpatioTemporal Augmentation。它从已有的视频—字幕数据出发,在空间和时间上组合短视频,再为组合后的新视频生成指令问答数据。
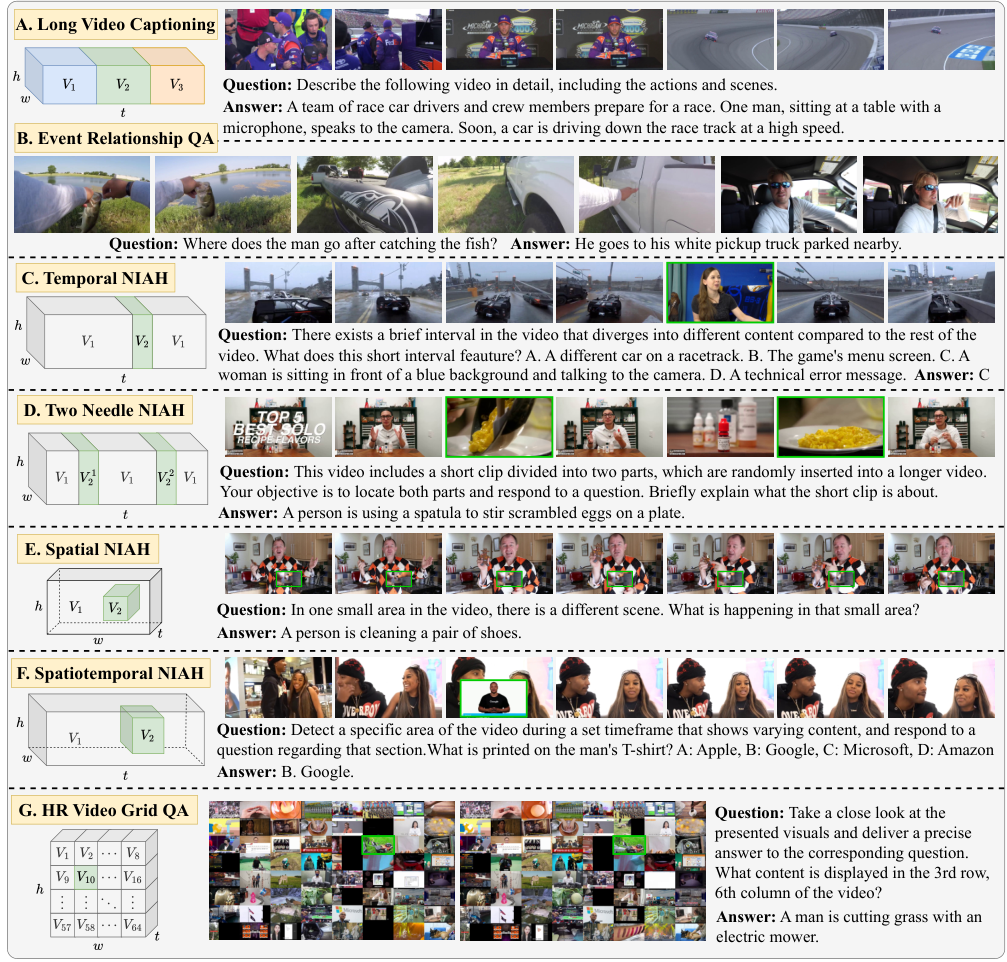
图:VISTA-400K 的视频增强与问答合成示意。图片来自 VISTA 论文,论文页面标注为 CC BY 4.0。
它的增强方式包括:
- 将多个片段首尾串联,构造更长的事件链;
- 将视频在空间上拼贴,要求模型定位局部区域;
- 将短片段插入更长的“背景视频”,形成时空 needle-in-a-haystack 任务;
- 将多个低分辨率视频排列成网格,测试模型在高分辨率画面中寻找细节的能力。
VISTA-400K 共包含约 40 万条视频指令数据。论文摘要报告,使用这些数据微调后,模型在四个长视频理解基准上的平均提升为 3.3%,在 HRVideoBench 上报告了 6.5% 的性能增益。这里需要注意,提升依赖具体模型、数据混合方式和评测设置,不能理解成任何视频模型都能稳定获得相同幅度的收益。
VISTA 的核心不是简单地“把视频拼长”,而是让新视频对应一个可验证的问题。没有高质量的问题和答案,时空组合只会增加视觉内容,不一定增加有效监督。
四、世界模型:直接生成原始数据中没有的场景
已有样本的裁剪、重组和拼接,始终受限于原始数据池。如果真实数据里没有“夜间暴雨、前车急刹、行人从盲区出现”这样的安全关键场景,组合操作也很难凭空创造它们。
Cosmos-Drive-Dreams 是世界基础模型用于自动驾驶合成数据的一个案例。它以 NVIDIA Cosmos 的驾驶领域模型为基础,尝试生成可控、多视角并且在时间上保持一致的驾驶视频,用来缓解长尾场景的数据不足。
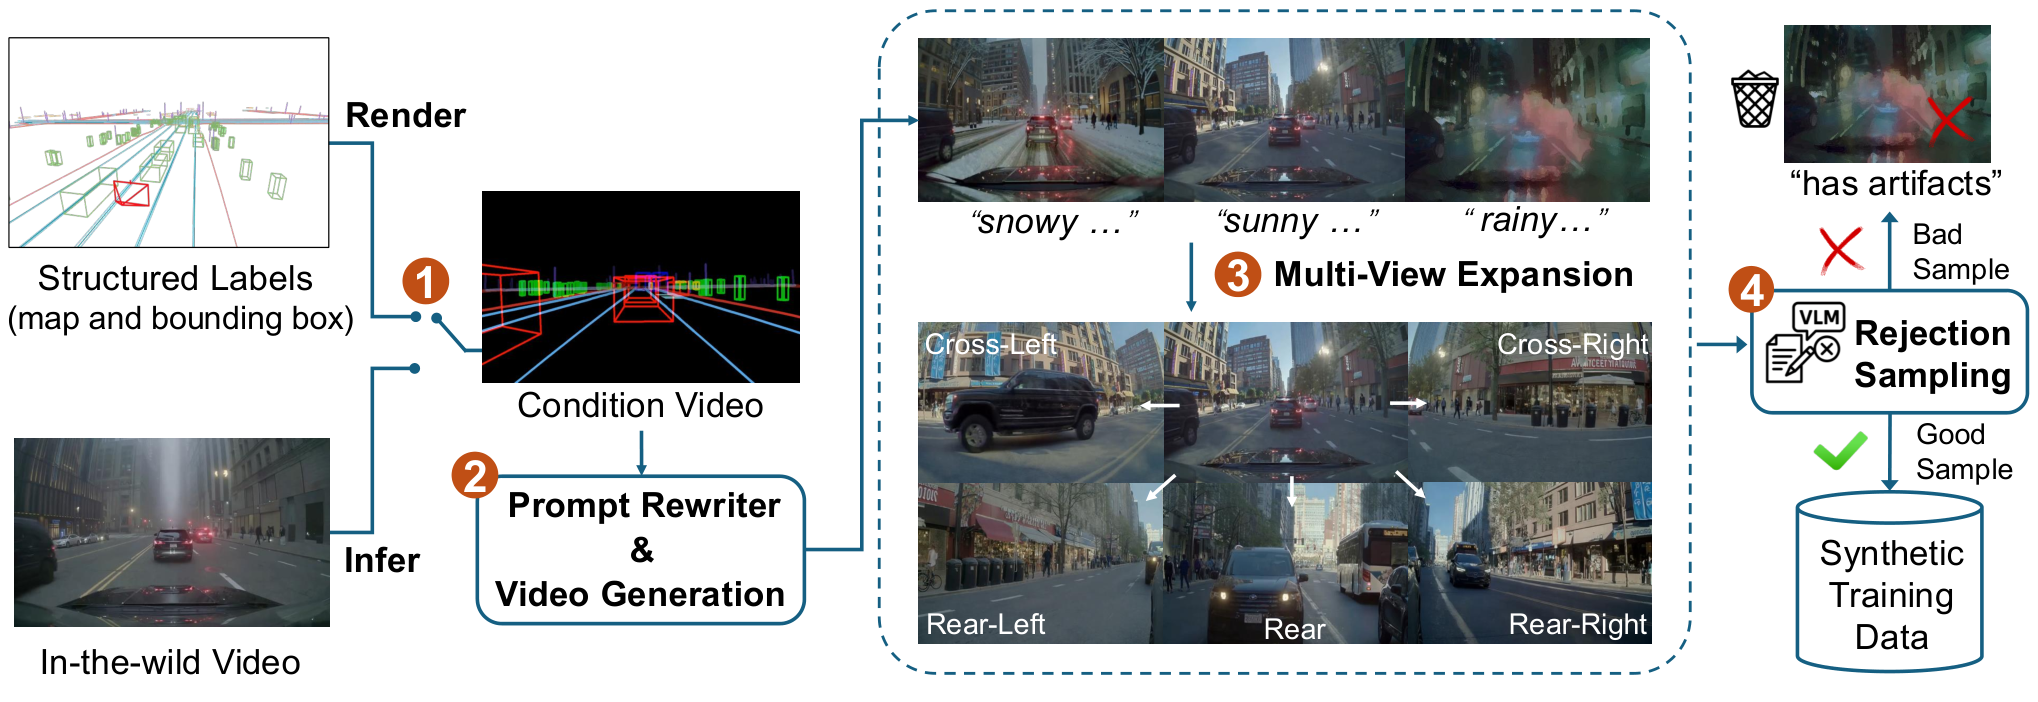
图:从结构化标签或真实视频,到条件视频、提示词改写、多视角扩展,再到 VLM 过滤的合成数据流程。图片来自 Cosmos-Drive-Dreams 论文,论文页面标注为 CC BY 4.0。
其流程可以简化为:
- 从地图、3D 框、深度或真实驾驶视频中获得结构化条件;
- 改写文本条件,生成不同天气、光照和交通参与者组合;
- 生成单视角视频,并进一步扩展为多视角视频;
- 使用 VLM 等质量过滤器拒绝存在伪影或条件不一致的样本;
- 将通过筛选的样本加入训练集,评估其对车道检测、目标检测和驾驶策略学习的影响。
这和 VISTA 有一个清晰区别:VISTA 主要是在已有素材上做时空排列组合;Cosmos-Drive-Dreams 则尝试生成原始数据中不存在的场景。前者扩展的是已有内容的组织方式,后者扩展的是内容分布本身。
在具身智能领域, WorldVLA 进一步把动作模型与世界模型放进同一个框架:动作模型根据图像和指令产生动作,世界模型根据当前状态与动作预测下一视觉状态。另一项近期预印本 Seeing Realism from Simulation 则尝试把仿真视频转换为更逼真的训练视频,同时保持任务语义和动作轨迹。这些工作说明,生成式增强的重点已经从“多生成一些样本”转向“生成对策略学习真正有帮助的样本”。
五、实际落地时的三个原则
1. 先定义语义不变量,再选择增强
增强操作应该围绕任务定义。分类任务也许允许颜色变化,但 OCR、空间关系、手部左右、交通信号和机器人动作通常不允许随意翻转或裁剪。对于图文对和视频动作对,增强图像的同时要检查文本、时间戳和动作标签是否仍然成立。
2. 质量控制比样本数量更重要
合成数据常见的问题包括视觉伪影、物体身份跳变、动作不连续、问答与视频不匹配、重复样本和分布泄漏。可以把自动过滤、去重、VLM 复核和人工抽检放在生成流程中,并在训练前保留一套独立验证集,确认增强数据是否真的改善了目标切片。
3. 用分层和闭环的方式增强
实际项目里通常不需要在一开始就上世界模型。可以先用 SimCLR 风格的像素增强建立基线,再针对模态偏置尝试 MIDAS 一类的错配训练;如果瓶颈是长视频,再引入 VISTA 的时空组合;只有当长尾场景确实缺失时,才考虑世界模型生成。
更稳妥的流程是:
评估薄弱环节 → 选择对应增强 → 生成并过滤 → 训练或推理 → 按错误切片重新评估
这个闭环比一次性生成大量数据更容易解释,也更容易发现增强策略是否正在放大错误。
总结
数据增强的演进,可以看成模型“见到什么”的不断扩展:
- SimCLR 让模型看到同一图像的不同视图,学习对无关变化保持稳定;
- VACoT 让 VLM 在推理时主动寻找更合适的视觉视图;
- MIDAS 用错配样本暴露并缓解多模态偏置;
- VISTA 用时空组合把短视频组织成长视频和高分辨率任务;
- Cosmos-Drive-Dreams 及相关世界模型工作,则开始生成真实数据中稀有甚至不存在的场景。
真正有效的增强不是盲目制造变化,而是让模型看到“任务需要、原始数据却没有充分覆盖”的变化。数据量只是起点,语义一致性、覆盖范围和可验证性才决定增强数据有没有教学价值。
参考资料
- SimCLR — A Simple Framework for Contrastive Learning of Visual Representations
- VACoT — Rethinking Visual Data Augmentation with VLMs
- MIDAS — Misalignment-based Data Augmentation Strategy for Imbalanced Multimodal Learning
- VISTA — Enhancing Long-Duration and High-Resolution Video Understanding
- Cosmos-Drive-Dreams — Scalable Synthetic Driving Data Generation with World Foundation Models
- WorldVLA — Towards Autoregressive Action World Model