同一个人、同一个场景,“打开盒子”和“关上盒子”可能拥有非常相似的单帧画面,区别藏在动作发生的顺序里。“假装拿起手机”和“真的拿起手机”,也需要观察物体有没有随手移动。
视频理解因此多了一层要求:模型既要知道每一帧里有什么,也要辨认帧与帧之间发生了什么变化。
C3D、I3D、TSM、TimeSformer 和 VideoMAE 分别展示了几种经典思路。不过,它们并不完全处于同一个比较维度:前四者主要讨论如何组织时空计算,VideoMAE 更侧重如何通过自监督预训练学到视频表征。
| 方法 | 代表性发表时间 | 核心思路 | 主要解决的问题 |
|---|---|---|---|
| C3D | 2014 预印本;ICCV 2015 | 在空间和时间上做三维卷积 | 从短片段提取时空特征 |
| I3D | CVPR 2017 | 将二维网络及预训练权重膨胀到三维 | 利用图像预训练初始化视频网络 |
| TSM | 2018 预印本;ICCV 2019 | 沿时间轴移动部分特征通道 | 以较低额外成本交换帧间信息 |
| TimeSformer | ICML 2021 | 分别计算时间与空间注意力 | 降低完整时空注意力的计算负担 |
| VideoMAE | NeurIPS 2022 | 高比例 tube masking 与重建 | 减少视频表征学习对人工标签的依赖 |
一、C3D:让卷积核同时看到相邻帧
C3D 的名称来自 Convolutional 3D。Du Tran 等人的 Learning Spatiotemporal Features with 3D Convolutional Networks于 2014 年公开预印本,发表于 ICCV 2015。
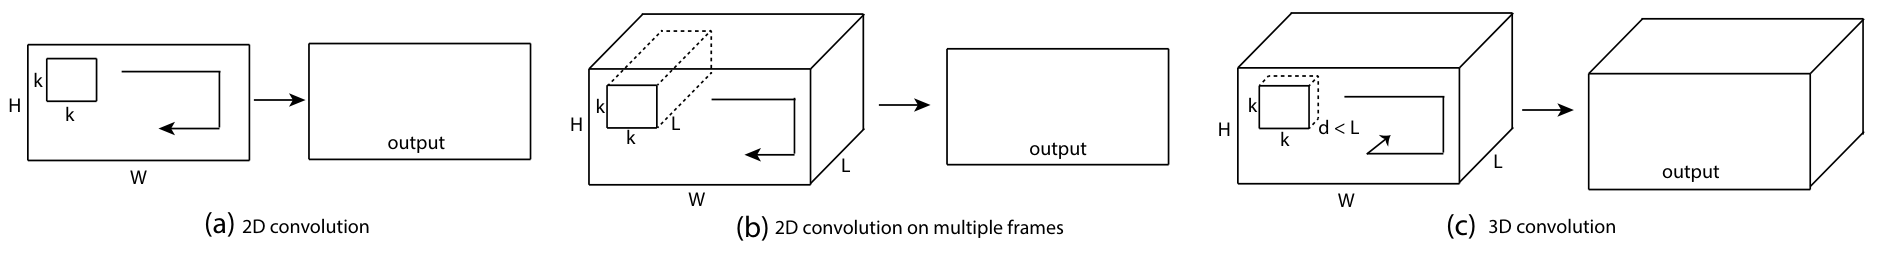
二维卷积处理一帧中的高和宽;三维卷积把时间也纳入局部窗口。一个 3×3×3 卷积核,会同时读取连续三个时间位置、每个位置上 3×3 的空间邻域。随着网络逐层计算,局部外观与短时变化可以共同进入特征。
论文中的 C3D 通常接收 16 帧片段,采用 3×3×3 卷积,包含 8 个卷积层、5 个池化层和两个全连接层,再接分类输出。第一层池化不压缩时间,以保留早期时序信息。这个明确结构比笼统称为“11 层浅层网络”更容易对应代码。原论文架构说明
以篮球视频为例,逐帧特征可以告诉模型球在哪里;三维卷积进一步接触相邻时间位置上的变化。但局部时空响应并不等于显式计算了光流,也不保证已经识别出完整的运动轨迹。
它是理解视频卷积的重要基线。实际成本要与分辨率、片段长度和骨干一起比较;不能因为采用三维卷积,就推断它在所有硬件、所有参照方法下都很慢。
二、I3D:把图像网络的知识带到视频里
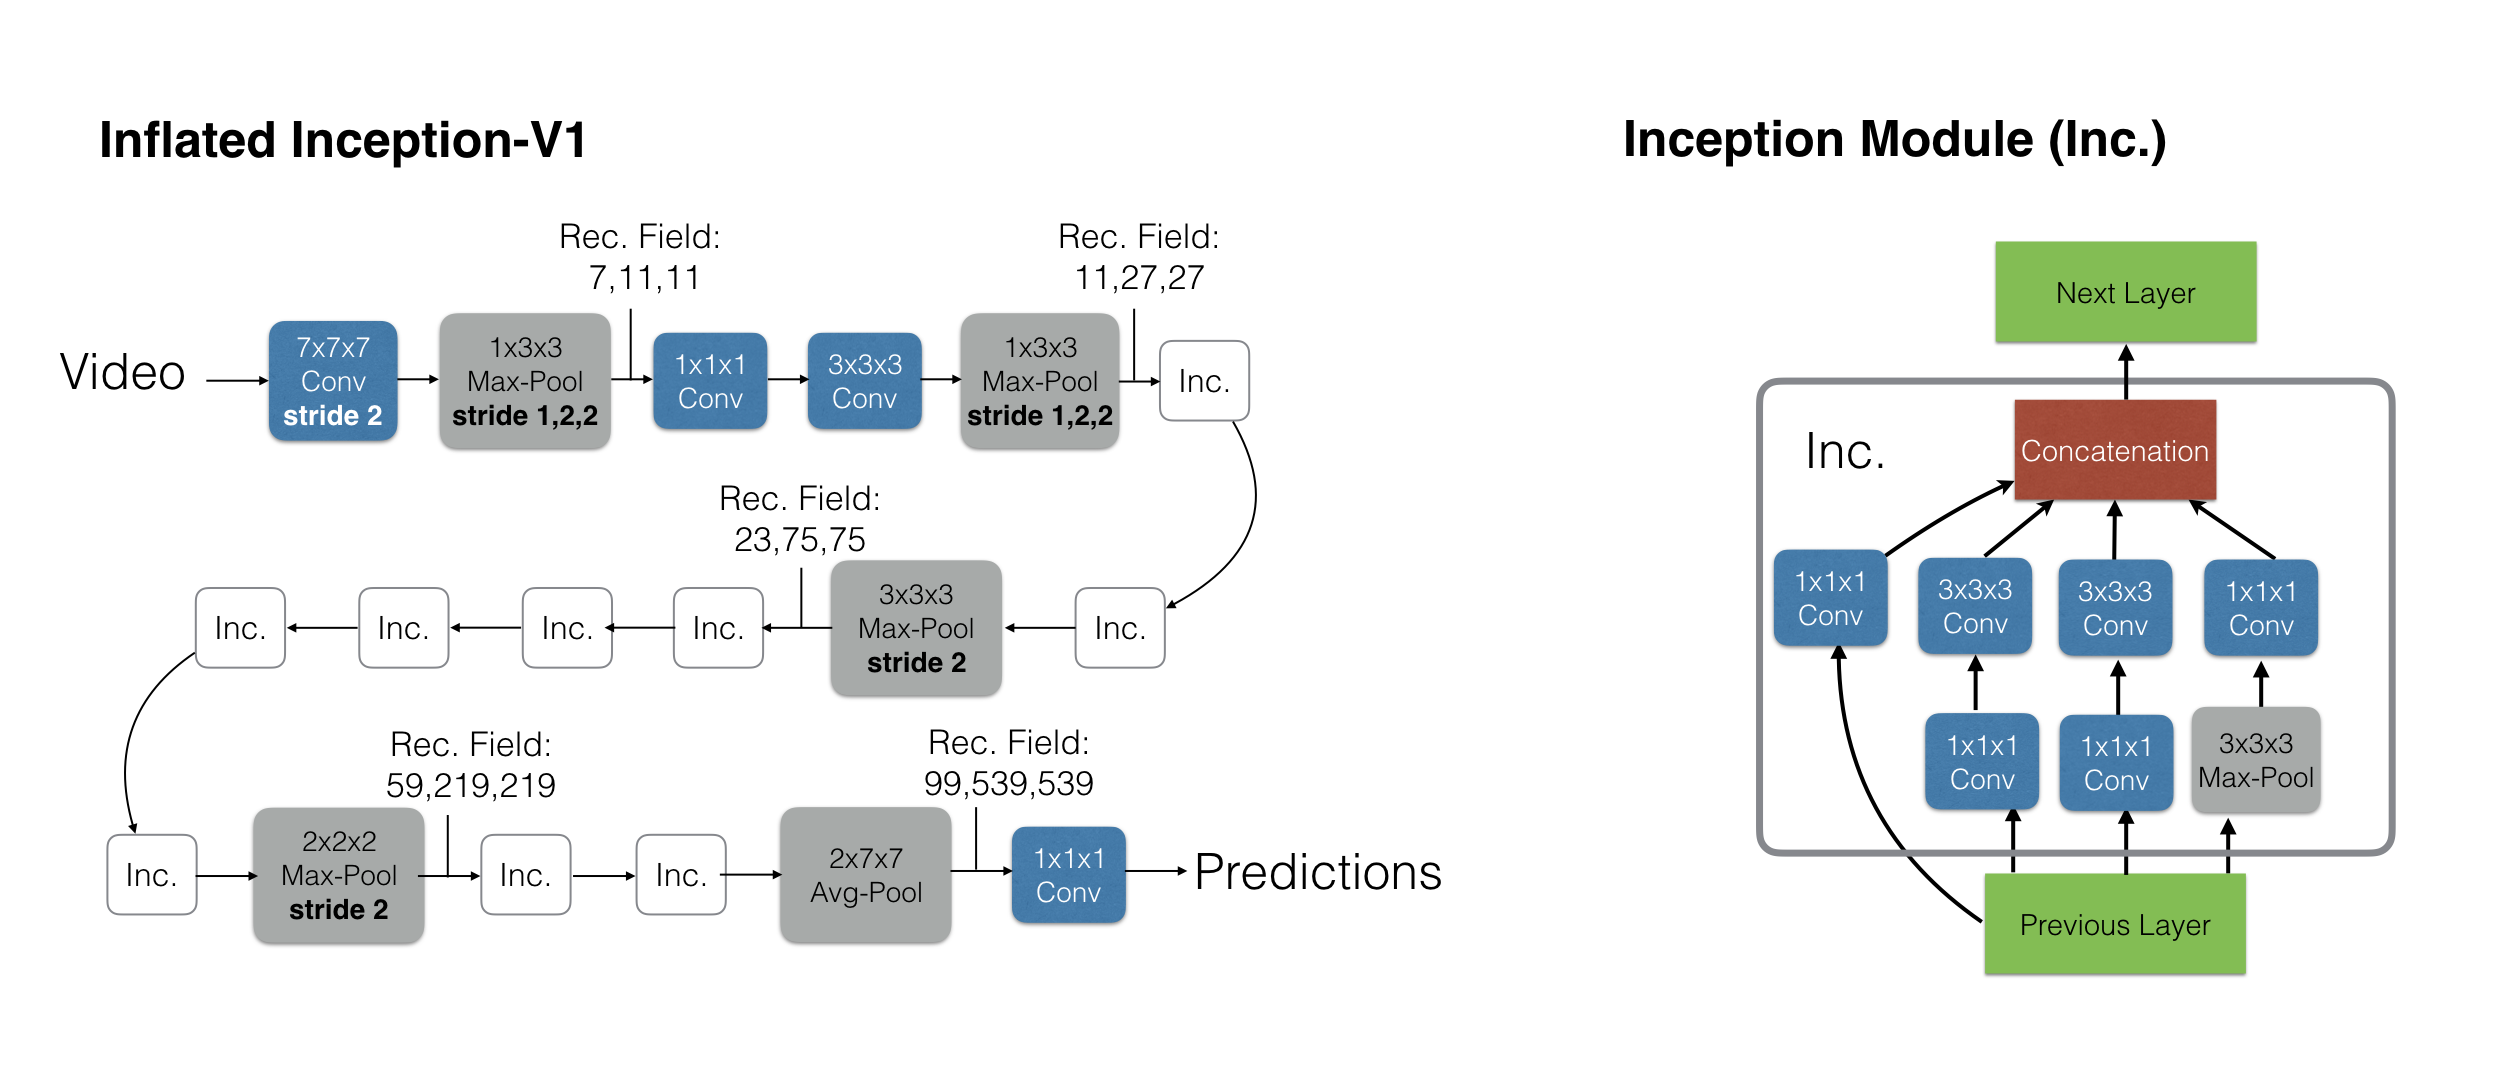
I3D 的全称是 Inflated 3D ConvNet。João Carreira 与 Andrew Zisserman 在 CVPR 2017 的 Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset中提出这一方法。
它将二维卷积与池化扩展到时间维度,利用成熟的图像网络结构和 ImageNet 预训练权重初始化视频模型。这里的“膨胀”指新增时间维度,不是空洞卷积里的 dilation。
权重初始化有一个关键细节:沿时间轴复制二维卷积核后,还要除以时间核大小。若时间长度为 k,可以写成:
W3D[τ, :, :] = W2D / k,τ = 0, 1, …, k−1对于多帧内容相同的静态片段,这样可以保持与二维滤波器相近的响应尺度。后续视频训练会继续更新这些权重,而不是只训练“新增的时间部分”。论文中的 inflation 说明
原论文还采用 RGB 与光流双流融合。RGB 提供外观信息,光流提供显式运动输入;使用 I3D 骨干本身并不强制同时运行两路。部署双流时,光流估计的时间与存储也应计入成本。
三、TSM:让二维卷积接触相邻帧特征
TSM 的全称是 Temporal Shift Module,即时序移位模块。Ji Lin、Chuang Gan 与 Song Han 的 TSM: Temporal Shift Module for Efficient Video Understanding于 2018 年公开预印本,发表于 ICCV 2019。
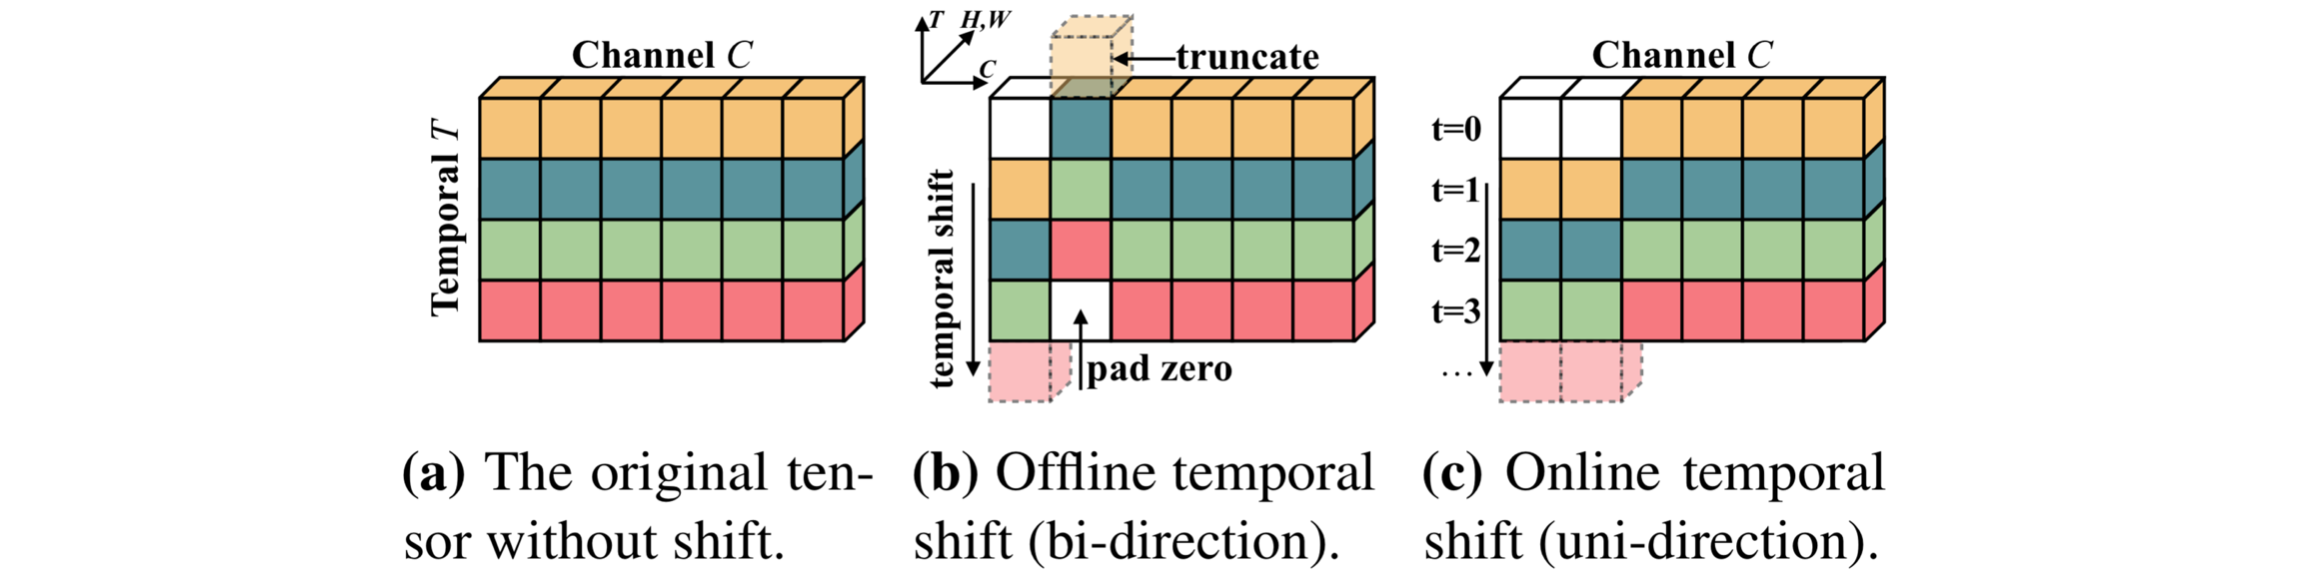
它的做法是在二维卷积之前,沿时间轴移动部分特征通道。移位后,某一时刻的特征同时包含当前帧与相邻帧的信息,随后由二维卷积混合这些通道。
通道通常不是平均分成三份。官方实现中常用的配置是:八分之一来自未来相邻帧,八分之一来自过去相邻帧,其余四分之三保持当前帧来源。比例可以配置。
以特征形状 (B, T, C, H, W) 表示,一个离线双向移位可以概括为:
部分通道:out[t] ← in[t+1]
部分通道:out[t] ← in[t−1]
其余通道:out[t] ← in[t]
序列边界需要单独处理;简单实现可以对不存在的邻帧填零。在线识别只能读取当前与过去的信息,因此需要单向移位与历史特征缓存,不能直接使用包含未来帧的离线版本。
“零参数、零额外计算”描述的是移位操作没有新增可学习参数和乘加运算。实际程序依然可能复制数据、分配缓冲区和访问显存,所以不能等同于零延迟。论文报告的 Jetson Nano 13 ms、Galaxy Note8 35 ms 是特定在线识别配置下的结果,换骨干、分辨率或运行环境后需要重新测量。
四、TimeSformer:把时间注意力和空间注意力分开
Gedas Bertasius、Heng Wang 与 Lorenzo Torresani 在 ICML 2021 发表了 Is Space-Time Attention All You Need for Video Understanding?,提出 TimeSformer。
设一段视频有 T 个采样帧,每帧有 P 个 patch。完整时空自注意力要处理 TP 个 token,注意力交互项随 T²P² 增长。帧数与图像分辨率同时增加时,这一项会迅速变大。
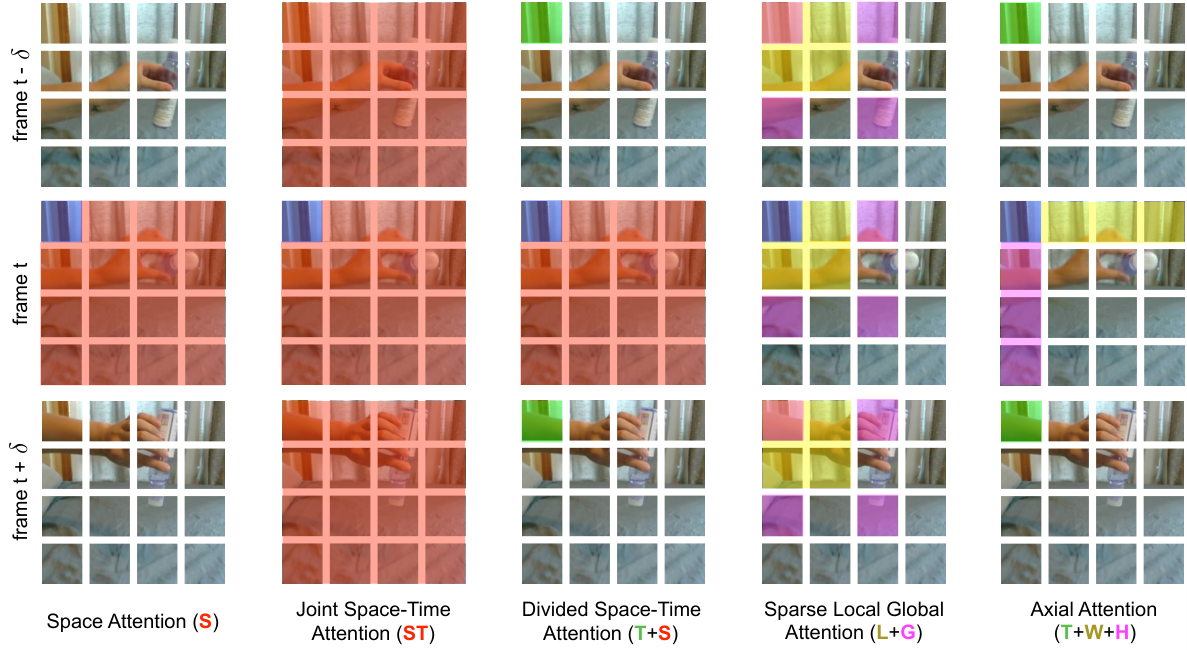
论文比较了多种注意力组织方式,其中 Divided Space-Time Attention 在每个 block 内先做时间注意力,再做空间注意力:先让同一空间位置的 token 跨帧交互,再让同一帧内的不同空间位置交互。论文
可以想象一张表格:每一行是一帧,每一列是一个 patch 位置。时间注意力沿列计算,空间注意力沿行计算。
忽略隐藏维度、特殊 token、投影和前馈层,仅比较注意力交互项,可以得到:
完整时空注意力:O(T²P²)
分解时空注意力:O(PT² + TP²)
它减少的是两个维度同时参与全连接交互的成本,不能简化成“从平方复杂度变成线性复杂度”。例如 T=16、P=196 时,上述交互数量约从 983 万降到 66.5 万;这是公式推导,不是整网速度提升倍数。
同一空间位置也不等于同一个物体:移动中的球会经过不同 patch。时间与空间注意力的组合仍需学习如何连接这些变化。
长视频能力还取决于采样。论文探索了覆盖一分钟以上的视频片段,但这不表示必须把一分钟内每个原始帧都送入网络。报告准确率或训练小时数时,应同时说明预训练数据、采样帧数、分辨率、硬件与测试视角,避免把不同设置当成公平速度对比。
五、VideoMAE:用掩码重建学习视频表征
VideoMAE 是 Video Masked Autoencoder。Zhan Tong、Yibing Song、Jue Wang 与 Limin Wang 的 VideoMAE: Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training发表于 NeurIPS 2022。
它将视频转换为时空 token,遮住大部分内容,只把可见 token 送入编码器。轻量解码器接收编码结果与 mask token,通过重建被遮挡内容学习表示。原论文探索了 90%–95% 的高掩码比例。
关键设计是 Tube Masking:在时间轴上共享空间掩码模式。某个空间位置被遮挡时,其对应的时间序列也一起遮挡,以降低直接从邻帧复制相似内容的机会。这是在固定网格上延伸的“管道”,并不是自动追踪移动物体的掩码。
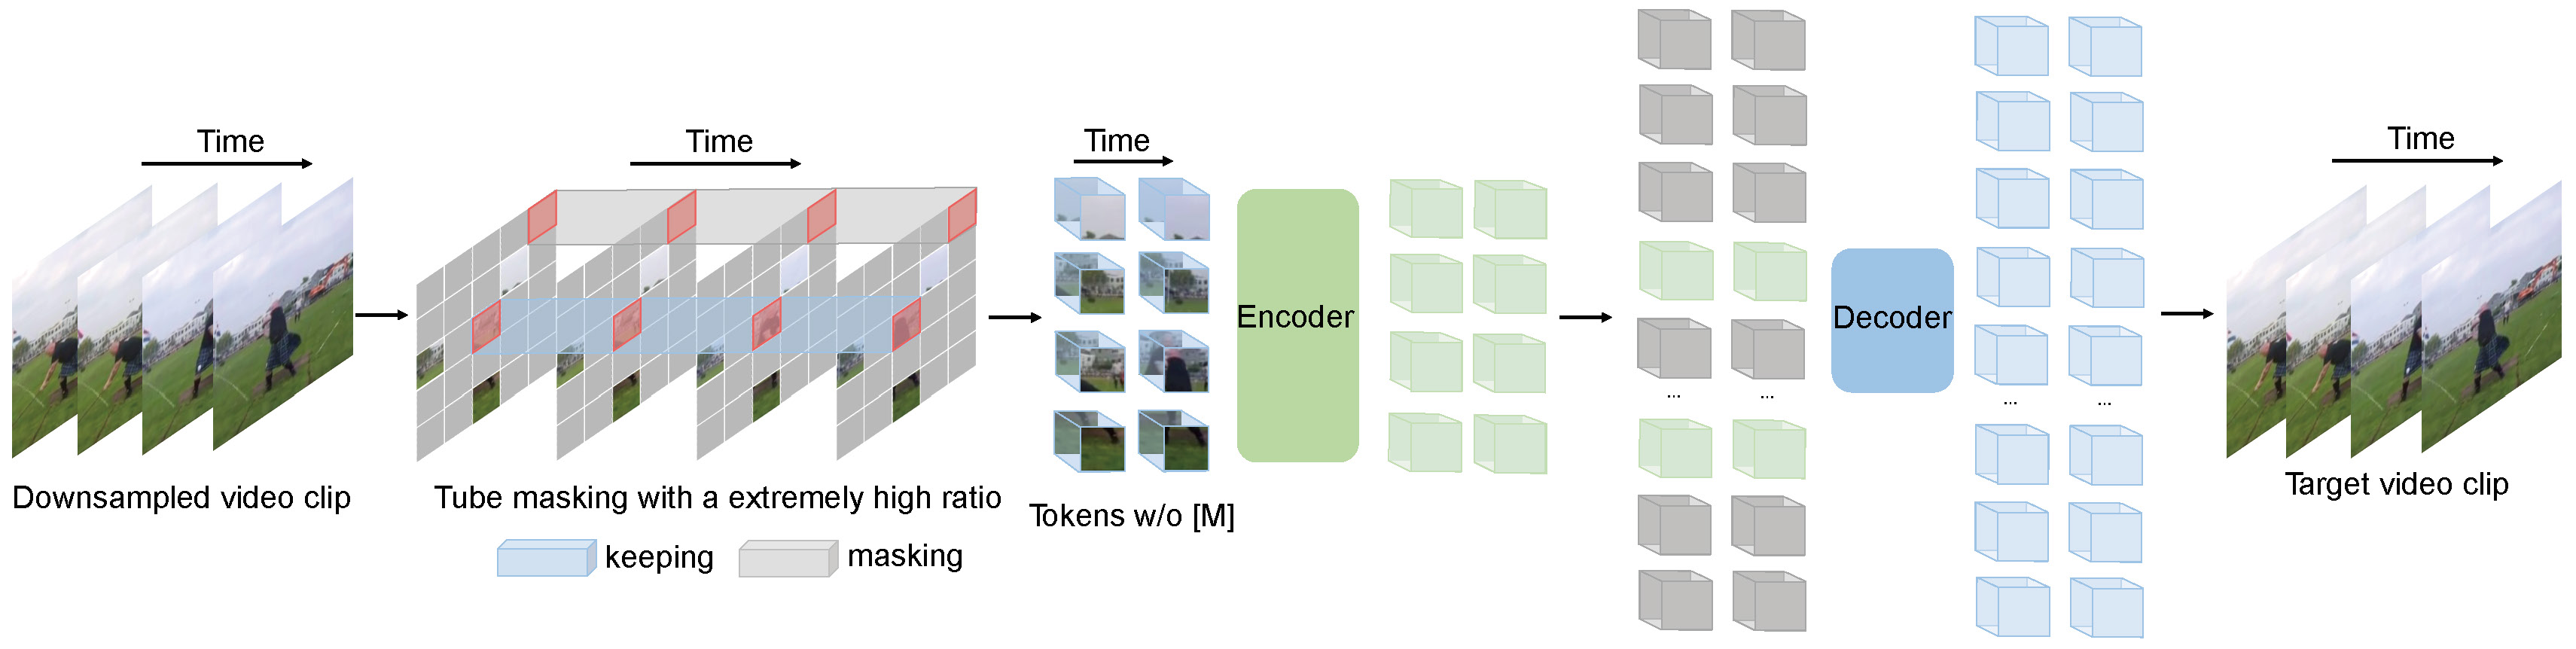
高掩码率与视频中的时间冗余有关。它使大编码器处理的 token 更少,但整体训练成本仍包含解码器和训练轮数。论文还报告了在约 3000–4000 条视频的小数据设置下学习有效表示的结果,这不保证任意小数据集都有同样收益。原论文
重建任务提供了一种自监督信号,并不证明模型已经理解全部动作或因果关系。用于动作识别时,通常保留编码器、移除预训练解码器,再接分类头并微调。完整片段分类的推理成本,也不能直接按预训练时“只保留 5%–10% token”估算。
六、怎样把这些方法放到同一次比较里
这五个名字可以沿三个问题整理:
- 帧间信息怎样交换? C3D/I3D 使用三维卷积,TSM 使用通道移位,TimeSformer 使用注意力。
- 模型怎样初始化和训练? I3D 复用二维权重,VideoMAE 从掩码重建获得预训练表示。
- 推理时允许看见哪些帧? 离线识别可以读取完整片段,在线系统必须限制未来信息并考虑缓存。
因此,VideoMAE 的出现没有让网络结构设计失去意义。骨干、预训练目标、采样方式与在线约束是可以分别研究的设计选择。
| 场景 | 可以建立的实验基线 | 应优先检查 |
|---|---|---|
| 边缘端连续识别 | 轻量二维骨干 + 在线 TSM | 历史缓存、逐帧延迟与内存搬运 |
| 有监督短片段识别 | I3D 等三维卷积基线 | 帧数、分辨率、单流或双流成本 |
| 跨较长时间范围聚合 | TimeSformer 类分解注意力 | 实际时间覆盖、采样密度与显存 |
| 标注有限但有未标注视频 | VideoMAE 预训练与微调 | 数据分布、预训练成本与迁移表现 |
这是一组实验起点,不是对所有部署环境的固定推荐。比较时先固定训练数据和评估协议,再决定更换哪个模块。
采样方式可能比模型名称更先限制效果
以 30 FPS 视频为例,取 16 帧、采样间隔为 4 个原始帧,首尾采样点间隔为 (16−1)×4/30 = 2 秒。相同的 16 帧,如果均匀覆盖一分钟,描述的时间范围完全不同。
稀疏采样能覆盖长过程,却可能漏掉一次快速接触;密集采样保留细节,却可能看不到动作的开始和结束。评估时应记录片段时长、采样帧数与采样策略,而不仅仅是输入张量形状。
还可以加入时间反转、打乱帧序和重复同一帧等诊断实验。例如,在依赖方向的类别上打乱顺序后性能几乎不变,值得检查模型是否主要依赖背景线索。解释结果时要结合标签:某些动作即使反转也不改变类别,不能机械地要求所有视频都对顺序敏感。
七、常见数据集应该怎样使用
Kinetics-400 是包含 400 类动作的视频分类基准,通常以约 24 万训练片段描述其规模。Kinetics 还存在其他版本,视频链接的可用性与实际下载数量也会变化,实验中应注明版本和有效样本数。数据集论文
Something-Something V2 更强调人与日常物体的细粒度交互。官方记录为 174 类、220,847 条视频,其中训练集 168,913 条、验证集 24,777 条、测试集 27,157 条。总量约 22 万不能写成训练集约 22 万;动作方向和操作过程也不等同于严格意义上的因果推断。官方数据集说明
UCF101 有 101 类、13,320 条视频,适合建立较小规模的动作识别实验。原始论文 HMDB51 也是经典小规模动作基准;VideoMAE 原论文同时报告了这两个数据集上的实验。使用它们时应遵循对应的数据划分和评估协议,避免同源片段跨训练与测试集造成泄漏。
实际项目还应加入自己的困难样本:动作方向相反、背景相似、目标被遮挡、镜头运动明显、动作持续时间变化大。它们更有助于判断模型是否学到了任务真正需要的时间信息。
参考资料
- C3D:Learning Spatiotemporal Features with 3D Convolutional Networks
- I3D:Quo Vadis, Action Recognition? A New Model and the Kinetics Dataset
- TSM:Temporal Shift Module for Efficient Video Understanding · 官方实现
- TimeSformer:Is Space-Time Attention All You Need for Video Understanding?
- VideoMAE:Masked Autoencoders are Data-Efficient Learners for Self-Supervised Video Pre-Training · 官方代码与配图
- Kinetics 数据集论文 · Something-Something V2 官方说明 · UCF101 数据集论文