“PPO 里的策略网络、价值网络、奖励模型和参考模型,究竟谁更新、谁冻结?”“这些网络的结构由算法规定,还是我们自己设计?”
理解强化学习时,这两个问题比记住一串算法缩写更有用。下面先分清模块职责,再看 Q-Learning、DQN、PPO、SAC 和 GRPO 如何使用它们,最后讨论选型与部署。
一、先分清策略、价值、奖励与参考模型
强化学习研究的是决策:智能体观察状态 ,选择动作 ,收到奖励 ,再进入新的状态。训练目标通常是提高长期累计回报,而不只是当前一步的分数。
| 模块 | 回答的问题 | 常见输入与输出 | 是否必需 |
|---|---|---|---|
| 策略(Actor) | 现在采取什么动作? | 状态 → 动作分布或确定性动作 | 显式策略方法需要;DQN 没有独立 Actor |
| 价值(Critic) | 当前状态或动作有多好? | 或 | PPO、SAC 使用;GRPO 不使用独立 Critic |
| 奖励模型 | 这个结果符合偏好吗? | 提示词与回答 → 分数 | 部分 RLHF 流程使用;规则奖励可替代 |
| 参考模型 | 新策略偏离基线多少? | 给定上下文 → token 概率 | 常见于语言模型对齐,不是所有 RL 都需要 |
策略网络:输出需要匹配动作空间
离散动作可以用 categorical 分布,例如输出各个游戏按键的 logits,再通过 softmax 得到概率。连续动作常用高斯分布,网络输出均值和标准差参数,也可以使用确定性策略或其他分布。
因此,softmax 和高斯分布是常见选择,而不是所有策略网络唯一合法的形式。算法要求的是动作接口和分布有效;MLP、CNN、Transformer、层数和宽度由任务与资源决定。
价值网络:区分 V 与 Q
状态价值 是一个标量,表示从状态 出发遵循某个策略的预期回报。动作价值 也是标量,但额外指定了当前动作。
DQN 通常输入一个状态,一次输出所有离散动作的 Q 值。因此输出是一个向量,其中每个元素都是一个 。不能把“价值网络只能输出一个数”当成统一规定。
奖励模型:偏好打分器
语言模型对齐中的奖励模型常接收提示词 和回答 ,输出 。它可以由预训练语言模型加一个标量打分头构成。
经典偏好训练使用回答对:同一个问题下,标注者认为 优于 。一种常见损失是:
这类分数主要表达相对偏好,并不天然对应“满分 10 分”的绝对量表。奖励还可以来自程序规则、环境反馈或其他评估器,不必全部来自人工偏好排序。
参考模型:提供分布基线
参考模型常由 SFT 检查点复制并冻结,用于计算策略与基线之间的 KL 散度。两者需要在兼容的 token 空间和上下文上给出可比较的分布,但内部网络结构不必数学上完全一致。
在常见 RLHF 实现中,使用同一个 SFT 检查点最方便,也能保留一个明确的初始基线。KL 惩罚有助于限制偏移,但不能保证彻底阻止奖励作弊或能力退化。
二、Q-Learning 与 DQN:从价值中选动作
Q-Learning:用一张表学习动作价值
Watkins 于 1989 年提出的 Q-Learning 是经典的离策略方法。它维护 Q 表,并用下面的更新规则改进估计:
其中 是学习率, 是折扣因子;若 是终止状态,后续价值项应为零。
以迷宫为例,每个格子是状态,上下左右是动作,到达出口给正奖励。智能体通过探索不断更新表格,最终可以在每个格子选择 Q 值最大的动作。探索阶段常使用 -greedy,而不是从头到尾只选当前最高分。
表格适合状态和动作较少的任务。图像、连续状态或大规模组合状态会让表格难以存储,也难以泛化。
DQN:让神经网络预测 Q 值
DQN 用 代替 Q 表。DeepMind 在 2013 年发表早期工作,并于 2015 年在 Nature 展示了代表性成果。输入是图像时可以用 CNN,输入是低维状态时可以用 MLP;输出维度通常等于离散动作数。
两个关键机制是:
- 经验回放:保存交互转移,训练时随机采样,降低相邻样本的相关性并复用数据。
- 目标网络:用更新较慢的网络计算自举目标,减轻目标随着当前网络变化而产生的不稳定。
目标网络通常通过周期性复制或缓慢更新来维护,它不是语言模型 RLHF 中的参考模型。前者用于稳定价值学习,后者用于衡量策略分布偏移。
训练结束后,DQN 可以直接根据 Q 网络输出选择动作,无需独立的策略网络。
三、PPO:同时学习策略与价值
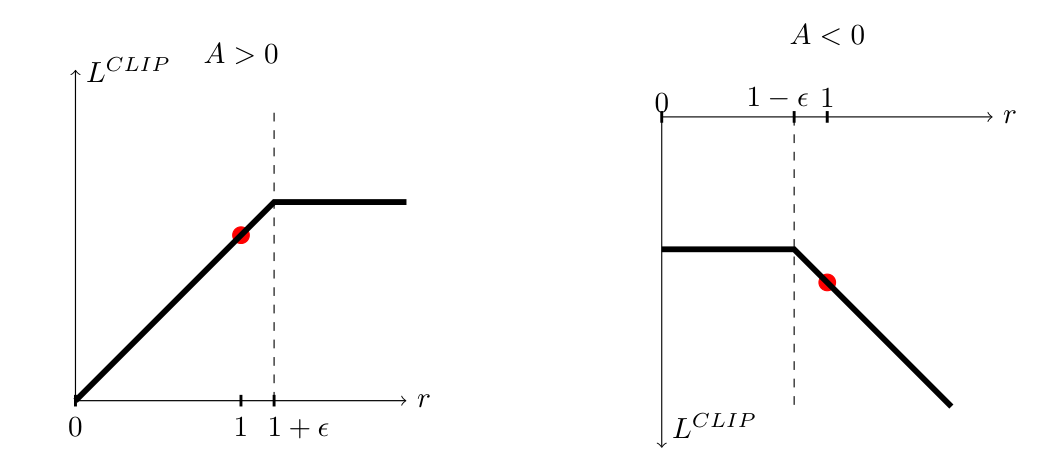
PPO 由 Schulman 等人在 2017 年提出。常见 Actor-Critic 实现中,策略负责产生动作,Critic 估计 ,用于计算优势并降低策略梯度的方差。
令新旧策略的动作概率比为:
PPO 的裁剪代理目标是:
它削弱过大更新带来的收益,鼓励较保守的策略改进。裁剪目标并不保证实际概率比永远处于区间内,也不是严格的 KL 上界。 工程上还会监控 KL、调整学习率或提前停止更新。
PPO 在机器人、游戏和语言模型对齐中都有应用。它通常需要新策略采集的数据,样本复用方式与 DQN、SAC 的离策略经验回放不同。
四、RLHF 与 SFT:流程与训练阶段
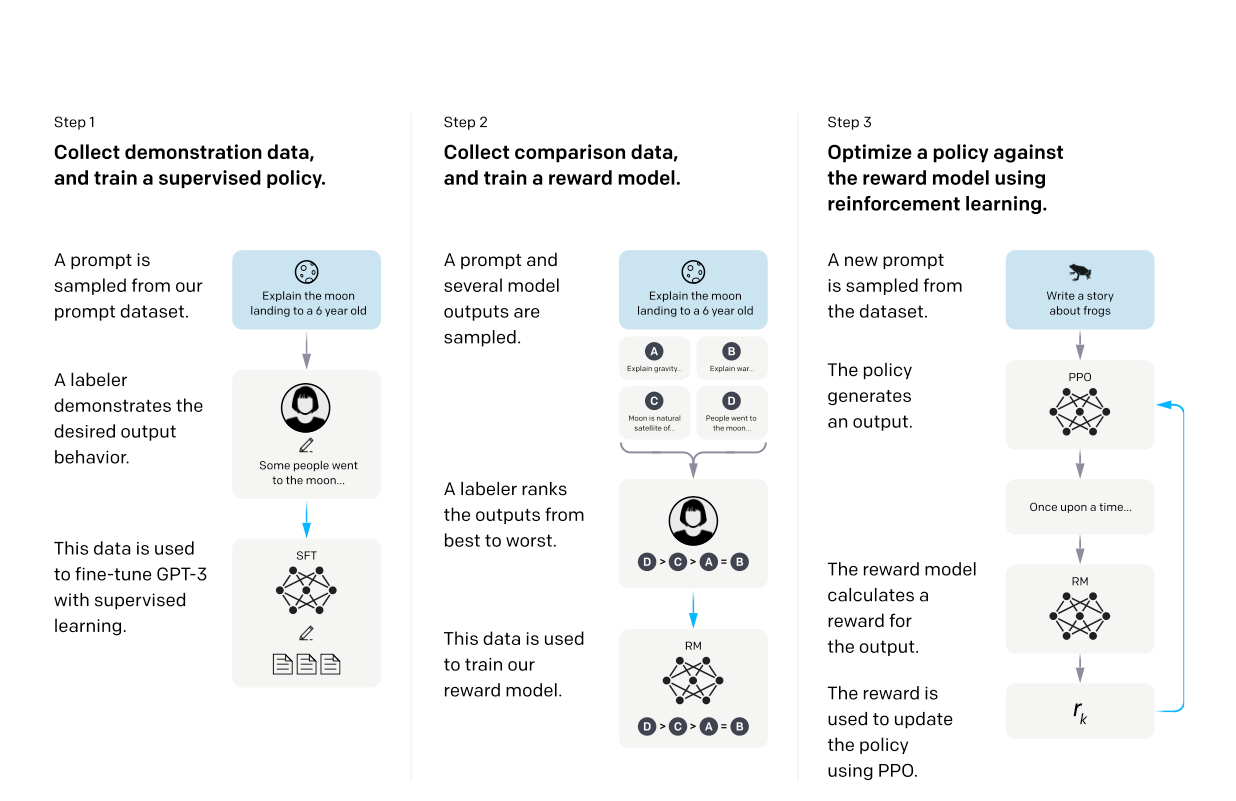
RLHF 是利用人类反馈学习奖励或改进策略的一类方法。Christiano 等人在 2017 年的工作是这一方向的代表性研究之一;它不是与 PPO、DQN 并列的单一更新算法。SFT 则是监督微调,也不是强化学习算法。
经典语言模型 RLHF 流程可以分为三个阶段:先用示范回答做 SFT,再用偏好数据训练奖励模型,最后使用 PPO 等方法优化策略。
在 PPO 对齐阶段,策略生成回答,奖励模型评分,参考模型提供 KL 基线,价值网络估计回报。常见的优化目标可概括为:
实际实现可能把 KL 拆成 token 级奖励或使用采样估计。这里还要区分两种基线:PPO 的旧策略是采样和计算概率比的依据,会随训练刷新;参考策略是用于对齐正则的基线,通常长期冻结。
策略和价值网络在这个阶段更新;奖励模型和参考模型通常冻结。奖励模型在此前的训练阶段当然需要更新,不能说它从来不训练。
五、SAC:连续控制中的熵正则与经验回放
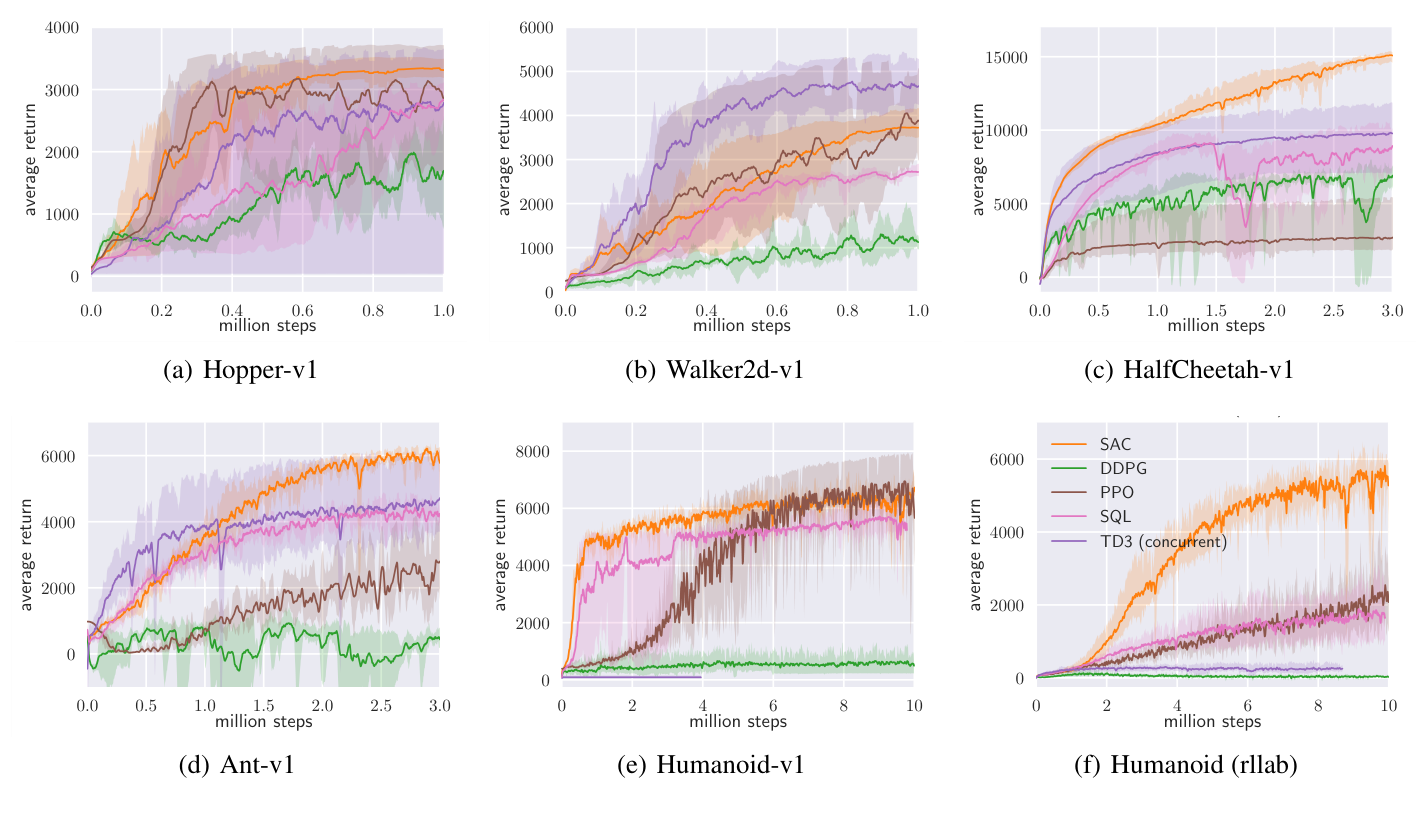
Haarnoja 等人在 2018 年提出 SAC(Soft Actor-Critic)。它在回报目标中加入策略熵,鼓励探索,并使用经验回放提高数据利用率。
现代常见实现维护一个随机 Actor、两个 Q Critic 和相应目标网络,不一定单独维护 网络;有些实现还自动学习熵温度参数。
连续动作常使用经过 tanh 变换的高斯分布,适配有界动作。标准差可以通过裁剪 log standard deviation 后取指数,或通过其他正值参数化得到,softplus 不是唯一要求。计算动作概率时,需要考虑 tanh 变换的修正。
SAC 常用于机械臂、运动控制等连续动作任务。它通常比 PPO 更能复用已有交互数据,但最终表现仍取决于环境、奖励、实现和调参。
六、GRPO:用组内相对奖励替代 Critic
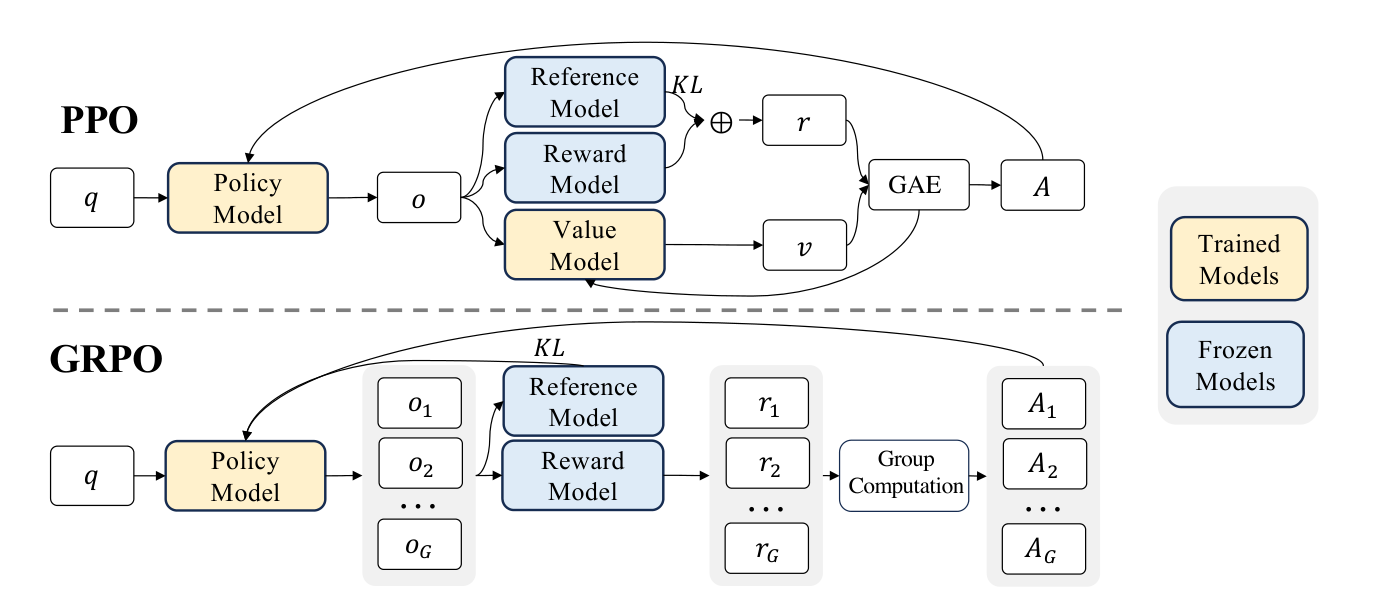
GRPO(Group Relative Policy Optimization)由 DeepSeek 在 2024 年的 DeepSeekMath 工作中提出。其主要特点是省去独立价值模型,通过同一个问题下的一组回答估计相对优势。
对问题 采样 个回答,得到奖励 。一种典型的组内标准化优势是:
策略根据这些相对优势优化,原始方法还使用概率比裁剪和参考策略 KL 正则。省去 Critic 可以降低训练资源需求,但一组回答的生成也有成本;若组内奖励全部相同,优势信号可能接近零。
奖励可以来自训练好的奖励模型,也可以来自规则,例如数学答案校验、代码测试或格式检查。原始 GRPO 使用参考模型,但一些后续实现会调整或关闭 KL 项,因此“GRPO 必须同时加载奖励模型和参考模型”不适用于所有配置。
七、哪些模块更新,最后部署谁
| 方法 | 训练中主要更新的对象 | 其他对象如何处理 | 常见部署对象 |
|---|---|---|---|
| Q-Learning | Q 表 | 无神经网络要求 | Q 表与动作选择逻辑 |
| DQN | 在线 Q 网络 | 目标 Q 网络周期同步或缓慢更新 | Q 网络 |
| PPO | Actor、Critic | 旧策略刷新;RLHF 中奖励和参考模型通常冻结 | Actor |
| SAC | Actor、Q Critic;可选熵温度 | 目标 Critic 缓慢更新 | Actor |
| GRPO | 策略模型 | 固定奖励来源;使用 KL 时参考模型通常冻结 | 策略模型 |
在语言模型对齐中,Actor 就是最终生成回答的语言模型。训练结束后,价值、奖励和参考模型通常不需要随它一起上线。但如果产品另外使用奖励模型做候选排序或过滤,它仍可能参与推理,这是额外的产品设计。
八、网络怎么设计,算法怎么选
网络设计先由数据和动作接口决定。低维状态可以从 MLP 起步,图像用 CNN 或视觉编码器,序列用 Transformer。Actor 输出动作或动作分布;Critic 输出状态价值、指定动作价值,或一组离散动作价值。Actor 和 Critic 可以分开,也可以共享部分骨干网络。
选型可以从下面的条件出发:
| 任务条件 | 可用起点 | 需要关注 |
|---|---|---|
| 状态和动作都很少、离散 | Q-Learning | 探索策略、表格规模 |
| 高维状态、离散动作 | DQN | 回放、目标网络、自举稳定性 |
| 可以大量采集交互、需要通用基线 | PPO | 优势估计、采样成本、更新幅度 |
| 连续动作、交互数据昂贵 | SAC | 数据复用、熵温度、Q 估计误差 |
| 语言模型对齐、已有奖励来源 | PPO 或 GRPO | 奖励质量、生成成本、KL、资源预算 |
强化学习适合优化决策和回报,尤其是动作会影响后续状态、奖励延迟出现或需要交互试错的任务。它不要求“完全没有标准答案”:数学题可以有明确答案,代码可以通过测试验证,这些都能提供规则奖励。
对于输入输出关系明确、已有充分标注的分类、检测、分割或回归任务,监督学习通常是更直接的起点。语言模型的训练也不必一开始就搭完整 RLHF 流程:先建立 SFT 基线,再判断是否需要偏好优化或强化学习。
规则奖励能减少训练奖励模型的成本,但仍要防止奖励漏洞。例如测试集覆盖不足时,“通过测试”不一定等于程序正确。
九、实践从小任务开始
入门可以用 PyTorch 和 Gymnasium 在 CartPole 上实现 DQN,理解状态、动作、奖励、回放和目标网络。随后用 TorchRL 或其他成熟库跑 PPO,观察 Actor、Critic 和优势估计如何协作。
语言模型训练可以参考 Hugging Face TRL 的 PPO 或 GRPO 文档。不同版本的 Trainer 接口、模型包装和参考策略管理方式会变化,应按实际安装版本配置。开始前需要准备数据、策略检查点和奖励来源,并明确批大小、采样数量、KL 系数、生成长度与评估集。
训练时除了看奖励,还应观察任务成功率、KL、回答长度、输出多样性和保留能力。奖励持续上涨并不自动代表真实质量提高。
贯穿这些方法的原则是:算法规定优化目标与接口,任务决定网络结构,奖励表达希望模型学会的行为。 PPO、SAC 和 GRPO 常部署策略;DQN 部署 Q 网络;Q-Learning 使用 Q 表。先理解最终决策由谁产生,再看训练阶段的辅助模块,算法之间的区别就会清楚很多。
参考资料
- Watkins 与 Dayan:Q-Learning
- Human-level control through deep reinforcement learning(DQN)
- Proximal Policy Optimization Algorithms
- Deep Reinforcement Learning from Human Preferences
- Training language models to follow instructions with human feedback
- Soft Actor-Critic
- DeepSeekMath:GRPO
- Gymnasium
- TorchRL
- Hugging Face TRL