在地址栏输入一个网址,几秒后页面出现;点击下载链接,文件逐渐落到磁盘。这些操作背后共享一条网络链路,但拿到响应后的处理方式不同。
理解这条链路,既能回答面试里的“输入网址到页面显示经历了什么”,也能帮助排查“网站打不开”“下载很慢”“文件下载到一半失败”等问题。以下以访问 https://www.baidu.com/ 为例说明一般机制;服务器侧结构是常见网站架构示例,不代表百度内部的实际实现。
一、先看完整链路
一个简化的网页访问过程是:
理解 URL、检查可用缓存
        ↓
解析域名,选择地址和连接路径
        ↓
建立或复用连接:TCP + TLS,或 QUIC
        ↓
发送 HTTP 请求,处理响应与重定向
        ↓
解析 HTML,获取 CSS、JS、图片等资源
        ↓
样式计算、布局、绘制、合成,显示并持续更新页面
这是逻辑上的顺序,不是一张必须逐项完成的清单。缓存命中可能跳过网络;连接复用可能跳过握手;资源下载、解析和渲染通常会并行或交错进行。

二、浏览器先理解网址,再决定是否需要联网
1. URL 不只是域名
一个网址可以包含协议、主机、端口、路径、查询参数和片段:
https://example.com:8443/docs?id=42#overview
  协议       主机     端口  路径  查询参数  片段
HTTP 默认端口是 80,HTTPS 默认端口是 443。显式写出 :8443 时,浏览器会使用该端口;没有写时,按协议采用默认值。直接输入 www.baidu.com 时,浏览器还会判断它是网址还是搜索词,并可能优先尝试 HTTPS。
片段 #overview 通常用于页面内部定位,不会作为 HTTP 请求目标发送给服务器。查询参数则通常属于请求目标的一部分。
2. 缓存有好几种
HTTP 缓存保存响应内容,DNS 缓存保存名称解析结果,连接池保存可复用的连接。这三者解决的问题不同。
页面也可能由 Service Worker 提供。若资源无需联网就能使用,后面的 DNS 和握手步骤可能不会发生;若缓存需要重新验证,浏览器仍会向服务器发送条件请求。
三、DNS:把名称映射到可连接的地址
DNS(Domain Name System)是分布式名称系统。浏览器可以获得 IPv4 地址记录(A)、IPv6 地址记录(AAAA),解析过程还可能涉及别名记录(CNAME)和其他记录。
系统如何查找名称,取决于浏览器、操作系统与网络配置。可能使用浏览器或系统缓存、hosts 文件、系统解析器,也可能通过浏览器配置的 DNS over HTTPS 服务查询。不能把它们的顺序写成所有设备都一致的固定流程。
递归解析器负责进一步查询
若所用的递归解析器没有可用缓存,它可以从根服务器获取顶级域线索,再向 .com 顶级域服务器查询,最后向相应权威服务器获取答案。浏览器通常不会亲自向根、顶级域和权威服务器逐个询问。
解析器经常已经缓存中间信息,因此实际查询未必走完整条链。缓存结果也有有效期,需要考虑 TTL。
DNS 与 CDN 的关系
网站可以通过 DNS、Anycast 路由、HTTP 重定向等方式把用户引导到边缘节点。CDN 不只靠“把域名换成最近服务器 IP”这一种机制,某个具体网站的解析结果也不一定就是 CDN 节点。
CDN 的“近”更接近网络可达性和性能:运营商互联、延迟、拥塞、节点负载和可用性都可能参与调度。物理位置近通常有利,但不能保证更快,也不能保证调度总能选出理论上延迟最低的节点。
四、连接怎么建立:TCP、TLS 与 QUIC
1. IP 和端口分别解决什么
IP 用于网络寻址,端口用于区分传输端点和服务。端口字段是 16 位,范围为 0~65535;0 是特殊保留值,不能当作普通服务端口随意使用。
| 端口 | 常见服务 | 说明 |
|---|---|---|
| 80 | HTTP | 常规明文 HTTP 默认端口 |
| 443 | HTTPS | TCP 上常见 HTTP/1.1、HTTP/2;UDP 上可承载 HTTP/3 |
| 22 | SSH | 远程登录与相关传输 |
| 25 | SMTP | 常用于邮件服务器之间传递邮件 |
| 53 | DNS | 传统 DNS 可使用 UDP 或 TCP |
网站也可以监听其他端口,但需要服务器、网络防火墙和客户端都允许。浏览器会限制部分端口,因此并不是任意数字都能用来提供网页服务。
2. TCP 三次握手
在典型的 HTTP/1.1 或 HTTP/2 新连接中,客户端与服务器先建立 TCP 连接:
客户端                           服务器
   ───── SYN,序号 x ────────────→
   ←──── SYN + ACK,序号 y,确认 x+1
   ───── ACK,确认 y+1 ──────────→
握手协商初始序列号与相关参数,建立连接状态。TCP 后续提供有序的字节流,通过序列号、确认、重传、流量控制和拥塞控制维持传输。它并不保留 HTTP 应用消息的边界,也不是每个网络包都对应一次单独确认。
若已有可复用连接,这次请求可以省去新的 TCP 握手。
3. HTTPS 的 TLS 握手
使用 HTTPS 时,需要建立受保护的通信。常见握手包含算法与协议协商、密钥协商,以及服务器证书验证。浏览器会检查证书链、主机名、有效期等条件,之后使用派生出的流量密钥加密应用数据。
不同 TLS 版本、会话恢复与实现细节会改变实际往返次数。TLS 保护通信内容的机密性和完整性,但不隐藏所有网络元信息:观察者仍可能看到地址、流量大小和时间等;域名是否被隐藏还取决于 DNS、ECH 等配置。
证书验证通过也不等于网站内容可信,它主要验证当前连接的身份与安全条件。
4. HTTP/3 不走 TCP
HTTP/3 使用 QUIC,QUIC 通常运行在 UDP 上并集成 TLS 1.3。可靠传输和拥塞控制由 QUIC 提供,所以“HTTPS 一定先做 TCP 三次握手,再做 TLS 握手”只适用于部分协议路径。
HTTP/2 在一条 TCP 连接上多路复用多个流,但 TCP 丢包可能阻塞同一连接上的其他流。QUIC 的流机制能减少这类跨流阻塞,仍然会受到带宽、丢包和拥塞影响。
五、HTTP:浏览器到底请求了什么
下面是便于阅读的 HTTP/1.1 请求示例,不是百度真实流量记录:
GET / HTTP/1.1
Host: www.baidu.com
User-Agent: ExampleBrowser/1.0
Accept: text/html
第一行包括方法、请求目标和版本。GET 表示获取资源,/ 表示根路径;Host 区分同一服务器托管的不同主机,Accept 表达希望接收的内容类型。符合条件时,浏览器还可能携带 Cookie,它可能参与会话管理,但不只是“登录信息”。

请求头后有空行,随后才是可选消息体。普通 GET 通常没有消息体;不应依赖 GET 消息体表达业务参数。
六、服务器返回什么
请求可能经过代理、CDN、WAF 和负载均衡,再到应用服务。边缘缓存命中时,它可以直接返回内容,不必每次访问源站。应用服务也可能读取缓存、查询数据库或调用其他服务。
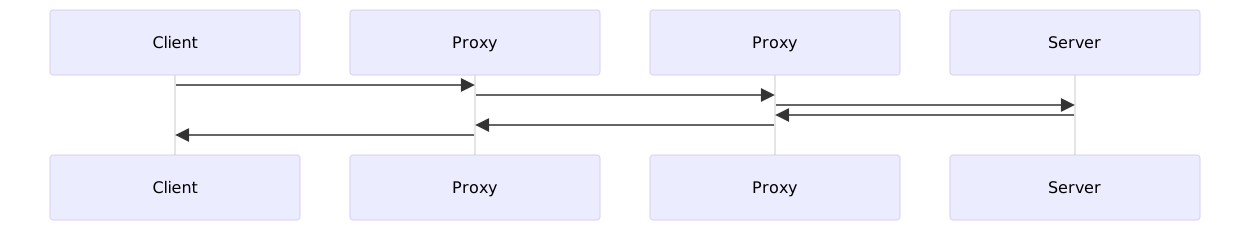
HTTP 响应包含状态信息、响应头,以及允许存在时的响应体:
| 状态码 | 常见含义 | 排查线索 |
|---|---|---|
| 200 | 请求成功 | 内容不一定正确,还要检查类型和正文 |
| 206 | 返回部分内容 | 常见于 Range 下载 |
| 301 / 302 | 重定向 | 检查 Location 与跳转后的域名 |
| 304 | 缓存验证通过 | 使用已有缓存响应,不是重新下载完整正文 |
| 401 / 403 | 认证或访问限制 | 检查身份、签名链接和权限 |
| 404 | 未找到资源 | 检查路径、部署版本和链接 |
| 500 / 502 / 504 | 服务或网关异常 | 结合源站、代理和超时日志判断 |
Content-Type 指示内容类型,Cache-Control 描述缓存策略。收到 200 也不能直接认定下载成功:登录页或错误提示可能同样以 200 返回。
七、HTML 到屏幕:解析、加载与渲染交错进行
浏览器可以在接收 HTML 的同时开始解析,构建 DOM。遇到样式表、脚本、图片和字体时,又会获取更多资源;这些资源可能来自不同域名,使用不同连接,或直接命中缓存。
CSS 参与样式计算。浏览器结合 DOM、样式与布局规则确定需要显示的内容,计算位置和尺寸,再绘制并合成到屏幕。页面不必等全部资源下载完成才第一次显示。
JavaScript 的执行方式也不一样:普通解析器插入的脚本可能阻塞 HTML 解析,defer、async 和模块脚本则有各自的加载与执行规则。后续脚本更新 DOM,字体或图片尺寸到达后,都可能引发新的样式计算和布局。
因此,把“渲染页面”写成第七步、“加载子资源”写成第八步,容易让人误以为它们完全串行。更准确的理解是:资源加载推动解析与渲染,渲染过程中又可能触发后续更新。
八、点击下载:相同的网络,不同的响应处理
点击文件链接同样会发起 HTTP 请求,必要时解析名称和建立连接,也可能复用已有连接。服务端会检查访问权限,并可能通过重定向将客户端引导到对象存储或 CDN。
302 并不是服务器把浏览器的原请求直接“转发过去”,而是向浏览器返回新的地址,浏览器再按规则请求它。签名下载 URL 常有有效期,过期后重试可能需要重新获取链接。
浏览器为什么有时展示、有时下载
处理方式受响应类型、浏览器能力、Content-Disposition、链接的 download 属性及用户设置影响。常见下载响应是:
Content-Type: application/octet-stream
Content-Disposition: attachment; filename="report.zip"
attachment 提示按附件处理。响应提供的文件名还会经过客户端安全处理,并非服务器能随意指定任意磁盘路径。
数据通常流式写入磁盘
浏览器通常边接收边缓冲并写入临时文件,而不是把整个大文件都保存在内存中。Chrome 常见 .crdownload,Firefox 常见 .part,具体行为随平台和版本变化。
传输结束后,浏览器可能完成长度检查、下载保护处理和文件重命名,但不能假定它一定计算了可信的内容哈希。TCP 的可靠字节流和 TLS 完整性保护也不等于验证“这个安装包确实是发布方的那一份”。需要更强验证时,应对照可信来源提供的 SHA-256 或数字签名。
九、Range:断点续传需要服务端支持
初次下载通常不需要 Range。恢复下载或请求分段时,客户端可以指定字节范围:
GET /large.zip HTTP/1.1
Host: example.com
Range: bytes=1048576-
If-Range: "file-version-etag"
这里表示希望从第 1,048,576 个字节偏移开始获取剩余内容。If-Range 可结合验证器判断文件版本是否仍匹配;实践中使用合适的强 ETag 等信息,避免把不同版本文件拼在一起。
支持且满足条件时,服务器可能返回:
HTTP/1.1 206 Partial Content
Content-Range: bytes 1048576-2097151/2097152
Content-Length: 1048576
服务器也可能忽略 Range 并返回完整的 200,或者返回 416 表示范围不满足。客户端必须检查状态和范围,不能直接把任何响应追加到旧文件。多个并发分段也不是所有浏览器下载的默认方式,过多并发可能触发限流。
十、怎么观察并排查这条链路
用浏览器开发者工具看页面
打开开发者工具的 Network 面板后重新加载页面,检查文档、脚本、样式和图片的请求瀑布图。重点看状态码、缓存来源、协议、重定向和 Timing;Timing 的具体展示随浏览器而异,复用连接时也可能不显示新的 DNS 或握手耗时。
“页面出来了”与“所有资源加载完成”是两件事。排查慢页面时,应区分首屏显示、脚本执行、布局抖动和后续接口响应。
用 curl 看连接与响应
在 Windows PowerShell 中显式使用 curl.exe,避免某些版本把 curl 解释成其他命令的别名:
curl.exe -v -o NUL https://www.baidu.com/macOS 或 Linux 可以使用:
curl -v -o /dev/null https://www.baidu.com/详细日志通常可以看到解析得到的地址、连接、TLS 信息、协商协议和请求响应头,但不会展示递归解析器查询根服务器的全过程,也不会渲染 HTML、执行网页脚本。日志可能包含 Cookie、令牌和签名 URL,分享前应清理。
观察跳转并下载文件,可以使用:
curl -L --fail --output report.zip https://example.com/report.zip尝试从已有文件继续下载:
curl -L --fail -C - --output report.zip https://example.com/report.zip这仍要求服务端支持续传、文件版本一致,而且链接有效。--fail 能识别部分 HTTP 错误,但无法保证一个 200 响应就是正确文件。
按出错阶段缩小范围
| 现象 | 优先检查 |
|---|---|
| 域名解析失败 | DNS 配置、网络可达性、记录和缓存 |
| 连接超时或拒绝 | 地址、路由、防火墙、端口、监听状态 |
| TLS 验证失败 | 证书链、域名、有效期、系统时间 |
| 重定向后 403 | 签名过期、鉴权、请求头和跳转目标 |
| 响应等待很久 | 边缘回源、服务处理、数据库、上游接口 |
| 文件传到一半失败 | 链路中断、代理超时、源站、限流、磁盘空间 |
| 文件完整收到但无法使用 | 内容类型、错误页面、版本、哈希和应用格式 |
| HTML 快但页面慢 | 子资源、脚本、主线程、字体与布局 |
一次失败可以来自多个层面。把日志时间、失败位置和请求目标对应起来,比笼统地判断“网络有问题”更容易找到原因。