给机器人一张当前画面,再告诉它“把红色方块推到左边”,模型最后该输出什么?一句文字描述、一个关节目标,还是未来一段时间的末端运动?
VLA(Vision-Language-Action,视觉—语言—动作模型)将视觉、指令与动作连接起来。其中,动作如何表示、如何生成,是影响计算成本与控制效果的重要选择。常见路线包括离散 token 自回归、扩散生成和 Flow Matching。
它们并不是简单的“离散快但粗糙、连续慢但精确”。动作分词方式、模型大小、采样步数、动作块长度和执行策略,会一起决定结果。
一、动作向量不一定是关节角
在讨论生成方式前,先明确模型与控制器之间的接口。同样是一个 7 维向量,可能表示三维末端平移、三维旋转及夹爪状态,也可能采用其他定义;它不自动等于七个关节的目标角度。
还要区分:绝对位置还是相对增量,机器人基坐标系还是工具坐标系,旋转使用什么表示,夹爪数值表示开合程度还是二值指令。数值相同但约定不同,机器人执行出的运动可能完全不同。
模型学习的可以写成条件分布:
p(A | 图像、语言指令、机器人状态或观测历史)

A 可以是单步动作 a_t,也可以是动作块 [a_t, …, a_(t+H−1)]。
其中的“或”很重要:不同模型接收的状态和历史并不相同。动作表示与生成算法也是两个独立选择——连续生成模型同样可以输出末端增量,不必输出关节轨迹。
二、离散 Token:把动作写成一串编号
RT-2 在 2023 年展示了将机器人动作编码进 VLM 输出空间的路线;OpenVLA 则在 2024 年发布了开放权重与训练实现,便于研究这一设计。RT-2 论文 · OpenVLA 项目
原始 OpenVLA 使用 DINOv2 与 SigLIP 融合视觉特征,经投影连接 Llama 2 7B,预测动作 token,再解码为机器人动作。它从 OXE 中整理约 97 万条机器人轨迹进行训练。官方架构说明
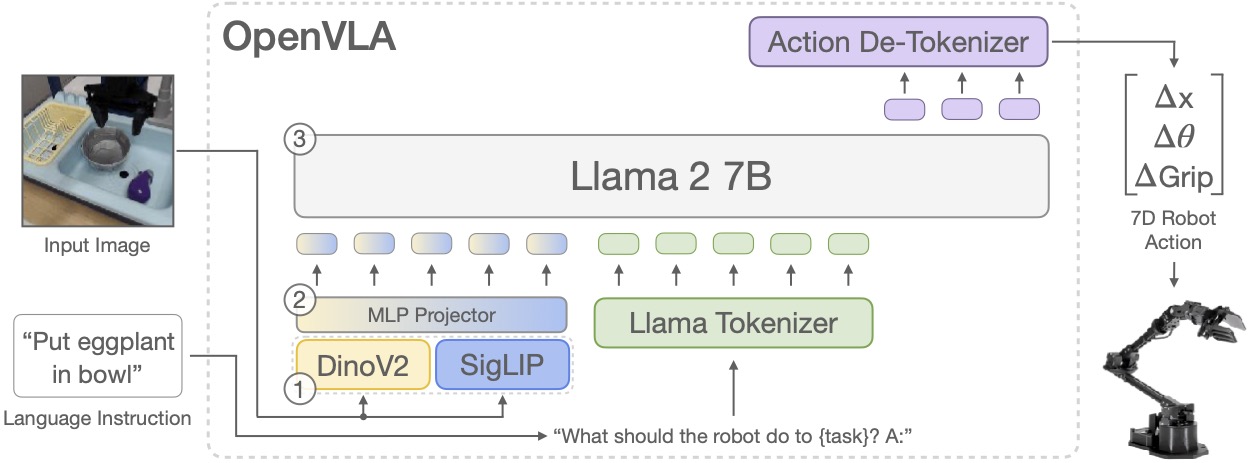
量化、预测、反量化
OpenVLA 将各动作维度分别离散为 256 个 bin。量化范围按训练动作的第 1 与第 99 百分位设定,以减小极端值对分辨率的影响。它复用词表中低频 token 表示动作编号,用 next-token prediction 训练,交叉熵损失只计算在动作 token 上。论文训练细节
对于 7 维动作,核心动作值对应 7 个 token;完整序列还可能包含终止等特殊标记。维度的含义由动作格式及序列位置确定,不必为每个关节创建一套独立词表。
一个纯示意的量化例子:假设某维平移增量的有效范围是 −0.10 到 0.10 米,均匀划成 256 格,每格宽约 0.78 毫米。这个数只描述设定区间内的量化粒度,不是机器人最终定位精度;相机误差、模型误差和底层控制误差仍然存在。
离散路线的优势是可以复用语言模型的序列建模工具,并表示多种可能的动作。代价是粗分桶有量化误差,逐 token 生成存在串行依赖。动作维度与时间跨度越大,朴素逐维分词的序列可能越长。
但“离散动作”不等于“永远逐维均匀分桶”。例如 openpi 同时提供基于 FAST 动作分词器的自回归 π0-FAST,因此不能用原始 OpenVLA 的分词方式概括整条路线。openpi 模型列表
三、扩散:从噪声中生成连续动作块
扩散策略直接建模连续动作分布。训练时给示范动作加噪,让网络在观测条件下学习去噪;推理时从噪声出发,迭代得到动作或动作块。Diffusion Policy 是这一方向的代表性工作,采用滚动时域执行来结合生成与反馈。Diffusion Policy 项目
为什么不直接用均方误差回归一个动作?设想绕过障碍物时向左、向右都是有效示范,简单回归可能预测出两者之间的平均方向。生成式策略可以表达多峰动作分布,但能否学到有效的多个模式,仍取决于数据与训练。
Octo:通用策略加轻量扩散头
Octo 的正式论文发表于 RSS 2024。它是支持语言或目标图像条件的通用机器人策略,不能简单等同于“一个大语言模型接扩散头”。官方提供约 2700 万参数的 Small 与约 9300 万参数的 Base 模型,并使用约 80 万条 OXE 轨迹预训练。论文 · 官方项目
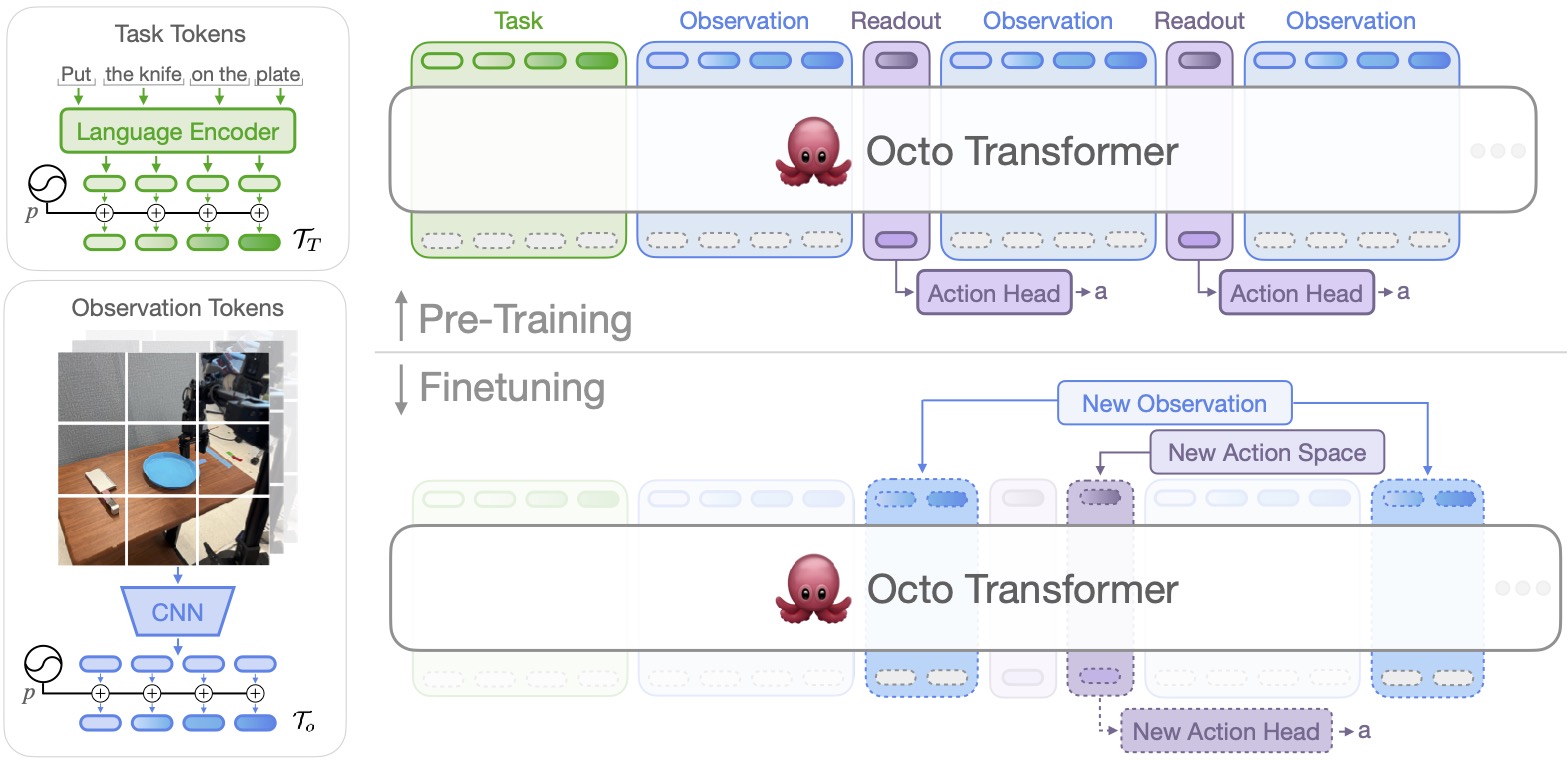
Octo 有一个影响速度判断的重要细节:一次动作预测只运行一次 Transformer 主干,多步去噪在较小的动作头中完成。因此,“扩散做了多步”不等于“整个大模型重跑了多次”。论文架构与动作解码说明
官方预训练模型使用长度为 4 的动作块。执行时可以执行全部四步,也可以只执行第一步后重新观察、重新预测;后者属于滚动时域控制。官方 FAQ
连续输出避免了逐维粗分桶,但不会自动消除抖动或保证精密装配成功。去噪步数、网络规模、接触反馈与控制器都会影响最终表现,也不宜把“13 次推理每秒”之类单一平台测试结果作为算法的固定速度。
四、Flow Matching:学习从噪声到动作的速度场
Flow Matching(流匹配)通过回归向量场来学习分布之间的变换。它与扩散模型有紧密联系,不能简单划成“一个随机、一个确定”的完全对立体系;扩散模型也存在确定性采样方式。Flow Matching 原论文
用一个方便理解的线性路径表示,令 z 是噪声,A 是示范动作块:
x_τ = (1−τ)z + τA,τ 从 0 走向 1
目标速度:u_τ = A − z
模型学习:v_θ(x_τ, τ, 观测条件)
采样更新:x_(τ+Δτ) ≈ x_τ + Δτ · v_θ(x_τ, τ, 条件)
这是解释性的时间方向约定,具体实现也可以反向定义 τ。需要特别注意:τ 是生成过程的时间,不是机器人执行动作的物理时间。 速度场描述的是整个动作块在生成空间中如何变化,而不是机械臂末端的实际运动速度。
所以,即使固定噪声后 ODE 积分是确定的,也不能推出机器人轨迹一定平滑、安全或无抖动。不同噪声仍可产生不同动作;动作块内外的连续性需要单独评估。
π0:VLM 与动作专家协同
Physical Intelligence 在 2024 年提出 π0,将 PaliGemma 初始化的视觉语言主干与较小的 action expert 结合。动作专家处理机器人状态及带噪动作块,在视觉语言条件下生成连续动作。π0 论文
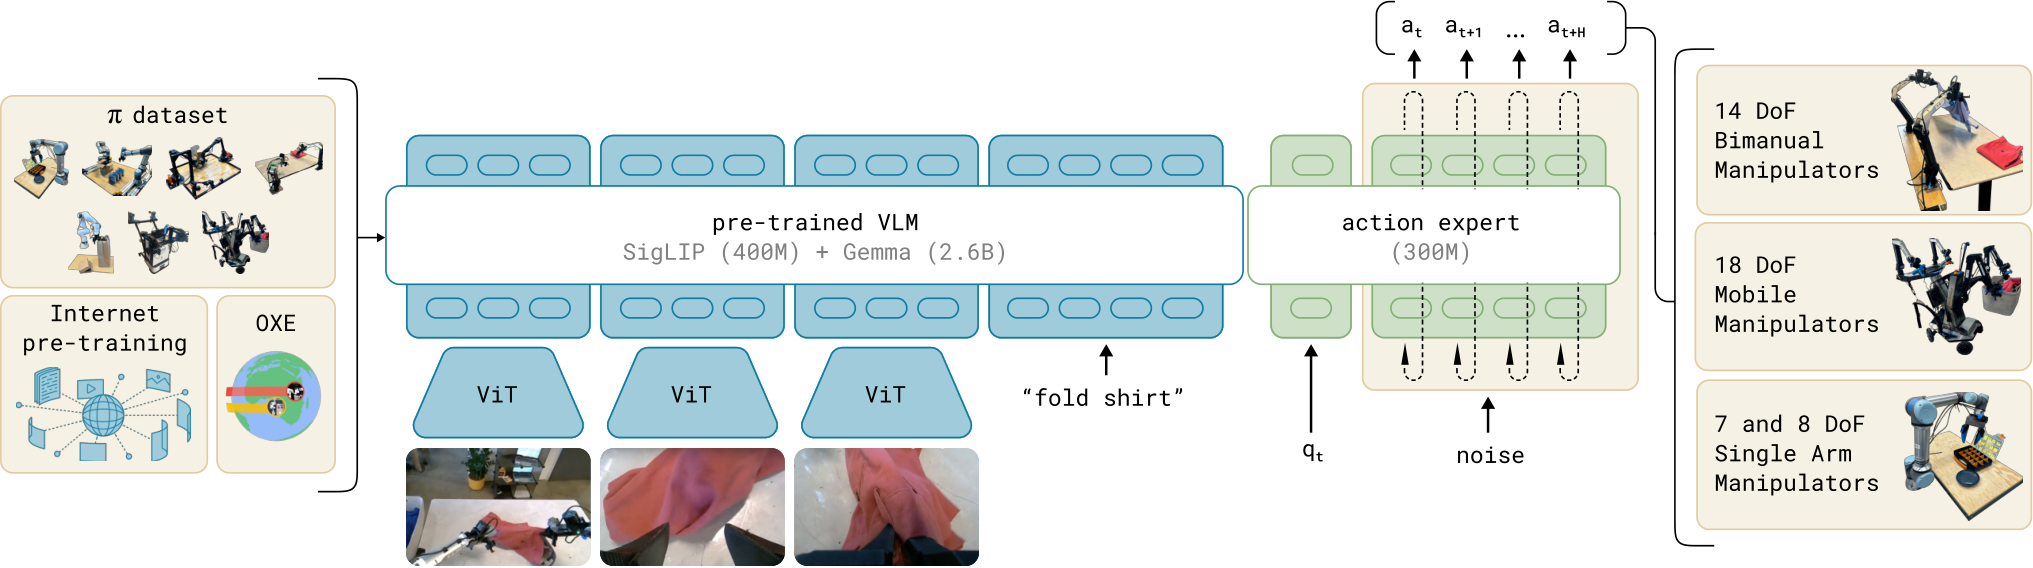
原论文的推理设置使用 10 步 flow matching,并缓存观测对应的 Key、Value,避免每一步都重复处理所有观测。这样的结构使少步生成具有实际价值,但“10 步”不是所有 Flow Matching 模型的普遍保证,也不能据此宣称它一定快于任意扩散策略。
截至本文更新时,官方 openpi 提供 π0、π0-FAST、π0.5 的模型与适配流程。仓库列出的单 GPU 显存估计为:推理大于 8 GB,LoRA 微调大于 22.5 GB,全量微调大于 70 GB。这些是特定实现的资源指引,实际还受 batch size、相机数、精度和配置影响;不是“任意 8 GB 显卡都能跑”。官方要求与检查点
五、三条路线应该怎样比较
| 路线 | 生成对象 | 主要计算特点 | 应重点检查的风险 |
|---|---|---|---|
| 离散自回归 | 动作编号序列 | 逐 token 生成;成本受分词长度影响 | 量化误差、串行延迟、解码与动作格式 |
| 扩散 | 连续动作或动作块 | 多步去噪;可只重复轻量动作头 | 采样成本、块间跳变、控制反馈 |
| Flow Matching | 连续动作块 | 沿学习到的速度场积分 | 步数与质量权衡、积分误差、块间衔接 |
这些差异不决定语义理解能力的固定排名。强语言能力来自主干、数据及训练策略,而不是“输出离散 token”这一选择本身;精密控制也不由连续输出单独保证。
公平比较至少需要固定机器人、任务、观测、动作表示、输出时域、硬件和成功判定。否则 6 Hz、8 Hz、13 Hz 可能分别描述不同大小模型、不同动作块的推理频率,并不能说明哪一种算法更适合高频控制。
六、Action Chunking:预测频率不等于执行频率
Action Chunking(动作分块)让模型一次预测未来 H 步。它适用于不同生成路线,而不是扩散或流匹配专属设计。
假设一次推理需要 300 ms,输出 25 步动作,每步执行 50 ms,那么整块覆盖 1.25 秒,动作命令的执行频率是 20 Hz。模型不需要每 50 ms 都完成一次完整推理。
但这只是时长算例,不说明系统已经具有低延迟反馈。若 25 步全部开环执行,期间物体移动或抓取失败,策略可能来不及纠正。常见设计选择包括:
- 滚动时域: 预测较长一段,只执行前几步,再采集新观测。
- 异步推理: 执行当前动作时准备下一块,同时处理观测时间戳、动作对齐与过期预测。
- 块间融合: 对重叠预测做时间集成等处理,但要检查是否引入滞后或混合了不兼容动作。
动作块内部也并非天然平滑;模型训练、动作表示和数据质量仍然重要。机器人底层伺服控制频率、动作命令频率、策略重规划频率,应分别报告。
七、数据集:先看接口和分布,再看规模
Open X-Embodiment:跨平台的数据集合
OXE 汇集多个机构与机器人平台的数据。原始工作描述了 22 种机器人形态、527 项技能和超过百万条轨迹,是研究跨平台迁移的重要资源。官方项目与论文
但它不是一份所有模型原样使用的固定训练包。OpenVLA 与 Octo 使用不同筛选、混合和预处理;π0 还结合大量自采数据。诸如“清洗后统一为 53 个数据集、32 TB”的说法必须绑定具体版本和处理管线,不能当成 OXE 的永久规格。
DROID:统一采集平台下的环境多样性
DROID(Distributed Robot Interaction Dataset)在原始发布中报告约 7.6 万条示范、350 小时交互数据、564 个场景与 86 类任务。官方数据集说明
统一硬件与采集流程有利于适配,但不意味着它在任何目标机器人上都比 OXE“更干净”或更合适。应检查目标相机视角、动作空间、操作物体和语言标注是否匹配,也应按模型版本核对它是否实际进入了预训练混合。
BridgeData V2:低成本桌面操作的重要资源
BridgeData V2 使用 WidowX 250 平台,官方统计为 60,096 条轨迹、24 个环境。其中 50,365 条是遥操作示范,9,731 条来自脚本策略,不能全部称为人工演示。官方数据组成
数据选择不应简单归纳成“预训练一定用 OXE、微调一定用 DROID”。最先需要核对的往往是动作单位与坐标系、旋转编码、夹爪方向、图像与动作时间同步、归一化统计,以及训练和评估是否存在场景重叠。
八、微调与评估:把失败原因分开定位
LoRA(Low-Rank Adaptation)是参数高效微调的一种选择,OpenVLA 和 openpi 都提供相关支持。但 rank 为 16 或 32 并不保证可训练参数恰好减少 100 倍:比例还取决于注入了哪些层和模块。LoRA 也不保证完全避免灾难性遗忘。OpenVLA 微调实验 · openpi
一个务实的实验顺序是:
- 用少量轨迹检查数据读取、图像时序和动作反归一化,确认示范回放符合预期。
- 在单一、可控任务上验证训练与推理链路,再扩展多任务和语言变化。
- 分别测视觉编码、动作生成、通信延迟,以及实际重规划频率。
- 在未见物体、相机变化与扰动条件下评估,并记录失败属于感知、指令理解、动作生成还是控制执行。
LIBERO 提供机器人操作与知识迁移的仿真评测,可作为可复现的实验工具,但不是所有 VLA 能力的唯一标准。报告时需注明任务套件、训练数据、评估协议与随机种子;仿真成功率不能代替真实机器人上的接触、延迟与安全验证。LIBERO 论文 · 官方实现
真实执行前,还应保留动作限幅、工作空间边界、急停与低速验证等独立保护。生成模型给出的是动作候选,不是安全证明。
最后可以把三条路线记成三句话:离散自回归学习“下一段动作编号是什么”;扩散学习“怎样逐步去掉动作中的噪声”;Flow Matching 学习“怎样沿速度场把噪声变成动作”。真正落地时,动作接口、数据与闭环执行,和生成方式一样重要。
参考资料
- RT-2:Vision-Language-Action Models Transfer Web Knowledge to Robotic Control
- OpenVLA:An Open-Source Vision-Language-Action Model · 官方项目与配图
- Octo:An Open-Source Generalist Robot Policy · 官方项目与配图
- Diffusion Policy · Flow Matching for Generative Modeling
- π0:A Vision-Language-Action Flow Model for General Robot Control · openpi 官方仓库
- Open X-Embodiment · DROID · BridgeData V2
- LIBERO