把一张图片交给多模态模型,模型接收到的往往不是“一张图”,而是一长串视觉 token。分辨率越高、视频帧数越多,这串序列就越长。
假设图片不经过缩放或额外裁剪,每个 patch 是 16×16 像素,448×448 的图片会产生 28×28=784 个 patch token;1024×1024 则有 64×64=4096 个。这里没有计入特殊 token,也没有考虑连接器的池化或重采样,不能直接当作任意视觉语言模型的实际输入长度。
问题在于:天空、墙面与重复纹理可能占据大量 token,而回答问题所需的信息并不均匀分布。视觉 token 压缩就是尝试用更短的序列保留足够的任务信息。
不过,“背景”并不天然无用。问杯子颜色时,白墙可能不重要;问墙上的小字时,同一区域就成了关键证据。压缩是有损取舍,不是找到一批永远可以删除的像素。
一、先区分:压缩发生在哪里
视觉编码器内压缩,与语言模型内压缩,节省的不是同一部分计算。
| 方法 | 代表性发表时间 | 主要作用位置 | 核心操作 | 训练或搜索要求 |
|---|---|---|---|---|
| EViT | ICLR 2022 | ViT 内部 | 保留重要 token,融合其余 token | 原方法结合训练或微调 |
| ToMe | ICLR 2023 | ViT 内部 | 按相似度合并 token | 可直接用于已有模型,也可配合训练 |
| DiffRate | ICCV 2023 | ViT 内部 | 联合剪枝、合并,学习各层压缩率 | 需要压缩率搜索;可复用已搜索配置 |
| FastV | ECCV 2024 | 多模态模型的 LLM 层内 | 根据注意力排序剪除视觉 token | 无需重新训练模型 |
如果压缩发生在 LLM 内,之前的视觉编码器已经完成了计算;如果发生在某个 ViT block 内,也只能减少该位置之后的相关开销。因此,不能把四种方法的加速数字直接排成一个排行榜。
二、EViT:保留重点,把其余信息打包
EViT 来自 Youwei Liang 等人的 Not All Patches are What You Need: Expediting Vision Transformers via Token Reorganizations,发表于 ICLR 2022。它使用分类 token([CLS])对图像 token 的注意力作为选择依据,而不是笼统地统计“谁与所有 token 的关联性最强”。论文
在选定的层中,模型完成多头自注意力后,保留得分较高的图像 token,并把其余 token 按注意力权重融合成一个额外 token,再继续后续计算。论文中的典型设置在第 4、7、10 层进行重组织。方法说明
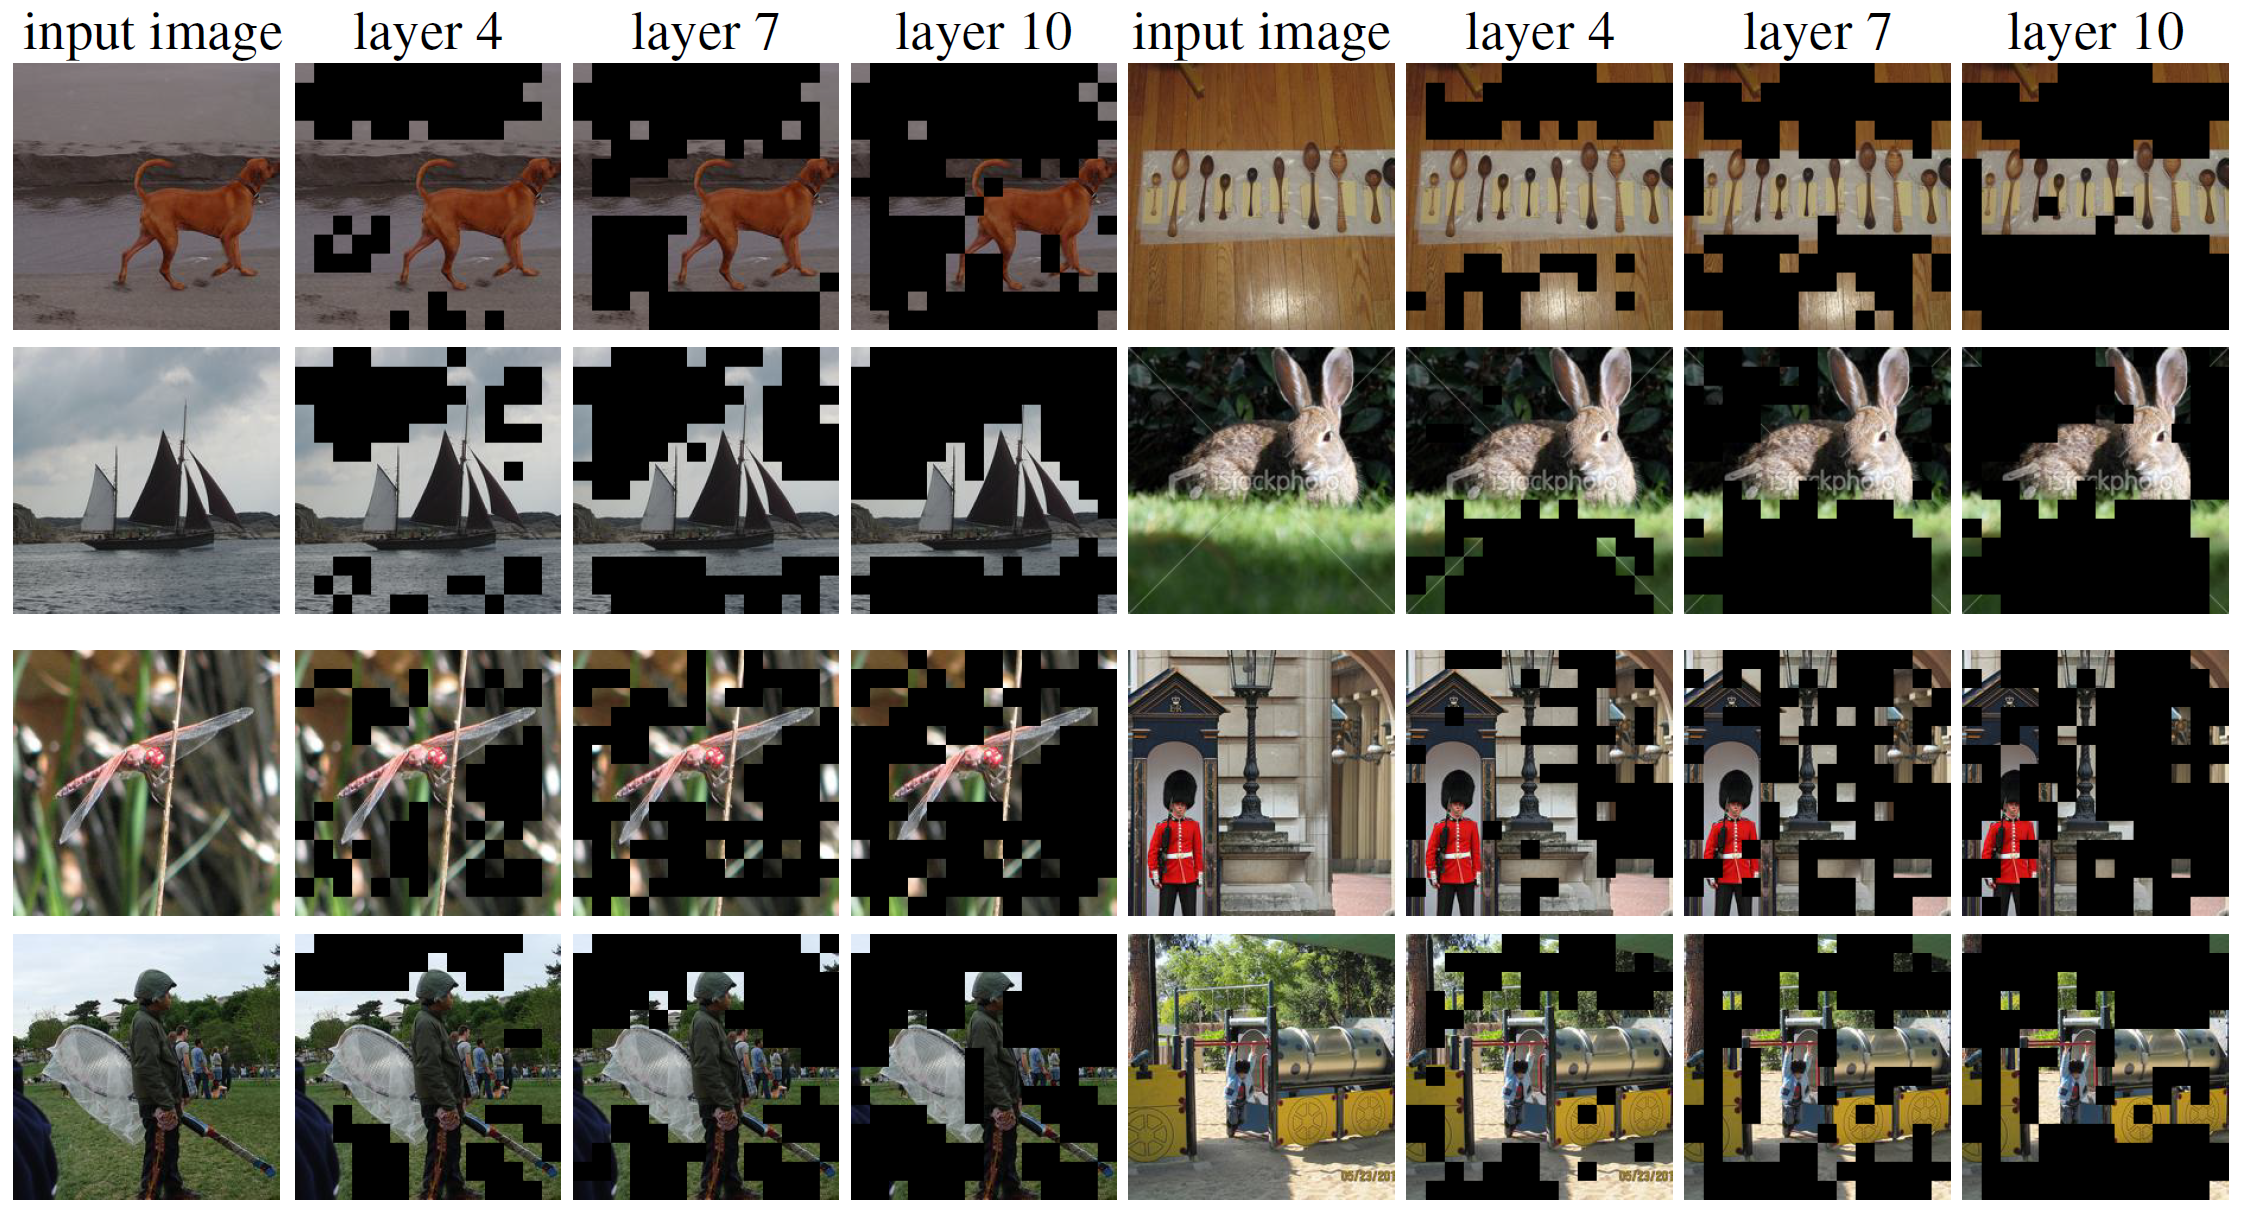
可以把它想成整理会议记录:重要发言单独留下,其他内容汇总成一段摘要。摘要避免了彻底删除,但也不再保留每句话的全部细节。
需要分清两件事:没有新增可学习的打分网络,不等于无需训练。 EViT 的原始方案将 token 重组织纳入训练;官方也提供训练、微调及对应权重。直接在任意预训练模型上删 token,并不能保证复现论文效果。官方使用说明
与它相关的 DynamicViT 使用轻量预测模块做动态选择,发表于 NeurIPS 2021,不是 2022 年。它可以作为“学习打分器”这条路线的对照。DynamicViT 论文
三、ToMe:把相似信息合成一个代表
ToMe 的全称是 Token Merging,来自 Daniel Bolya 等人的 Token Merging: Your ViT But Faster,发表于 ICLR 2023。它不只压缩背景,也可以合并前景中重复的纹理或部件表示。官方项目
其二部图软匹配可以概括为:
- 将 token 交错分成 A、B 两组。
- 利用注意力中的 Key 特征计算相似度,为 A 中每个 token 找到 B 中最相似的目标。
- 选出相似度最高的若干条连接,将对应特征聚合,再拼回序列。
这不是严格的一对一配对:多个源 token 可以汇入同一目标,也不要求它们在图像中相邻。合并模块位于注意力与 MLP 分支之间。论文方法部分
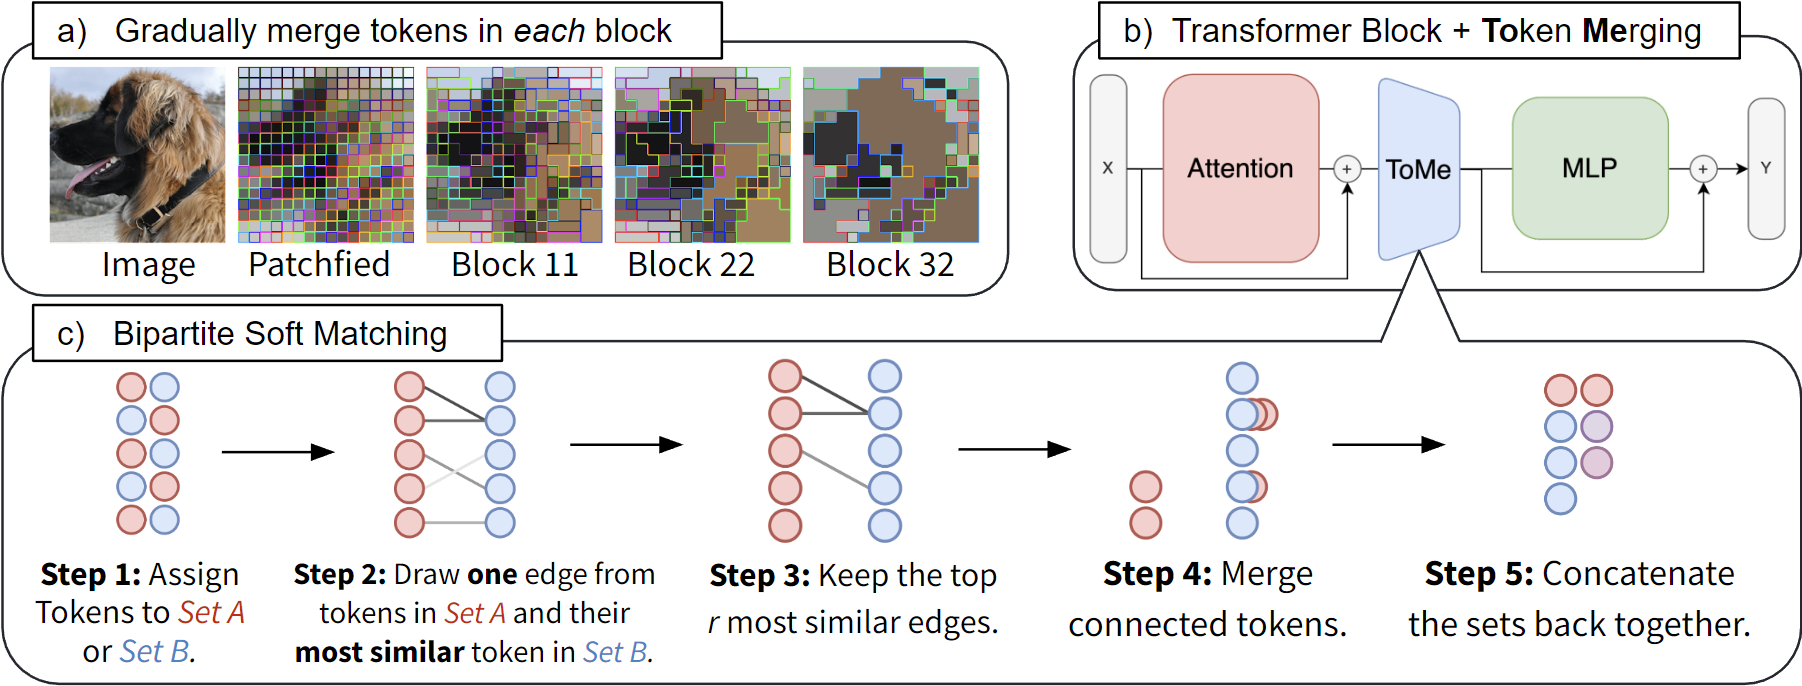
合并多次之后,一个 token 可能代表许多原始 patch。ToMe 跟踪这个“大小”,用它加权聚合特征,并通过 proportional attention 调整注意力。对于两个代表大小分别为 s₁、s₂ 的特征,聚合可以写成:
x_new = (s₁ × x₁ + s₂ × x₂) / (s₁ + s₂)
s_new = s₁ + s₂
加权平均仍然是有损操作。杯身的相似纹理可以被概括,但两个小字符的细微差别也可能被抹平。“保留了多个 token 的贡献”不等于“信息完全没丢”。
ToMe 可以不重新训练就用于已有 ViT,也可以在训练时启用以改善精度与效率。官方报告的加速依赖模型和配置,不能把某个压缩比例绑定成固定速度或显存收益。尤其要区分原始 ToMe 与 Token Merging for Fast Stable Diffusion:后者是面向扩散模型的单独工作,其结果不能直接套到视觉编码器上。ToMe 官方说明 · 扩散模型版本
四、FastV:在语言模型里减少视觉 token
FastV 来自 Liang Chen 等人的 An Image is Worth 1/2 Tokens After Layer 2,发表于 ECCV 2024。它关注的不是 ViT 如何看图,而是视觉表示进入 LLM 后,是否仍需要在所有深层保留完整视觉序列。论文 · 官方实现
它让前面的层正常处理输入,在指定层 K 根据收到的注意力对视觉 token 排序,剪除比例为 R 的低分视觉 token,再继续后续层。论文描述的评分使用 token 收到的平均注意力;复现时还需核对具体实现的注意力头聚合及 query 位置,不能一概写成“所有文本 token 的注意力总和”。方法说明
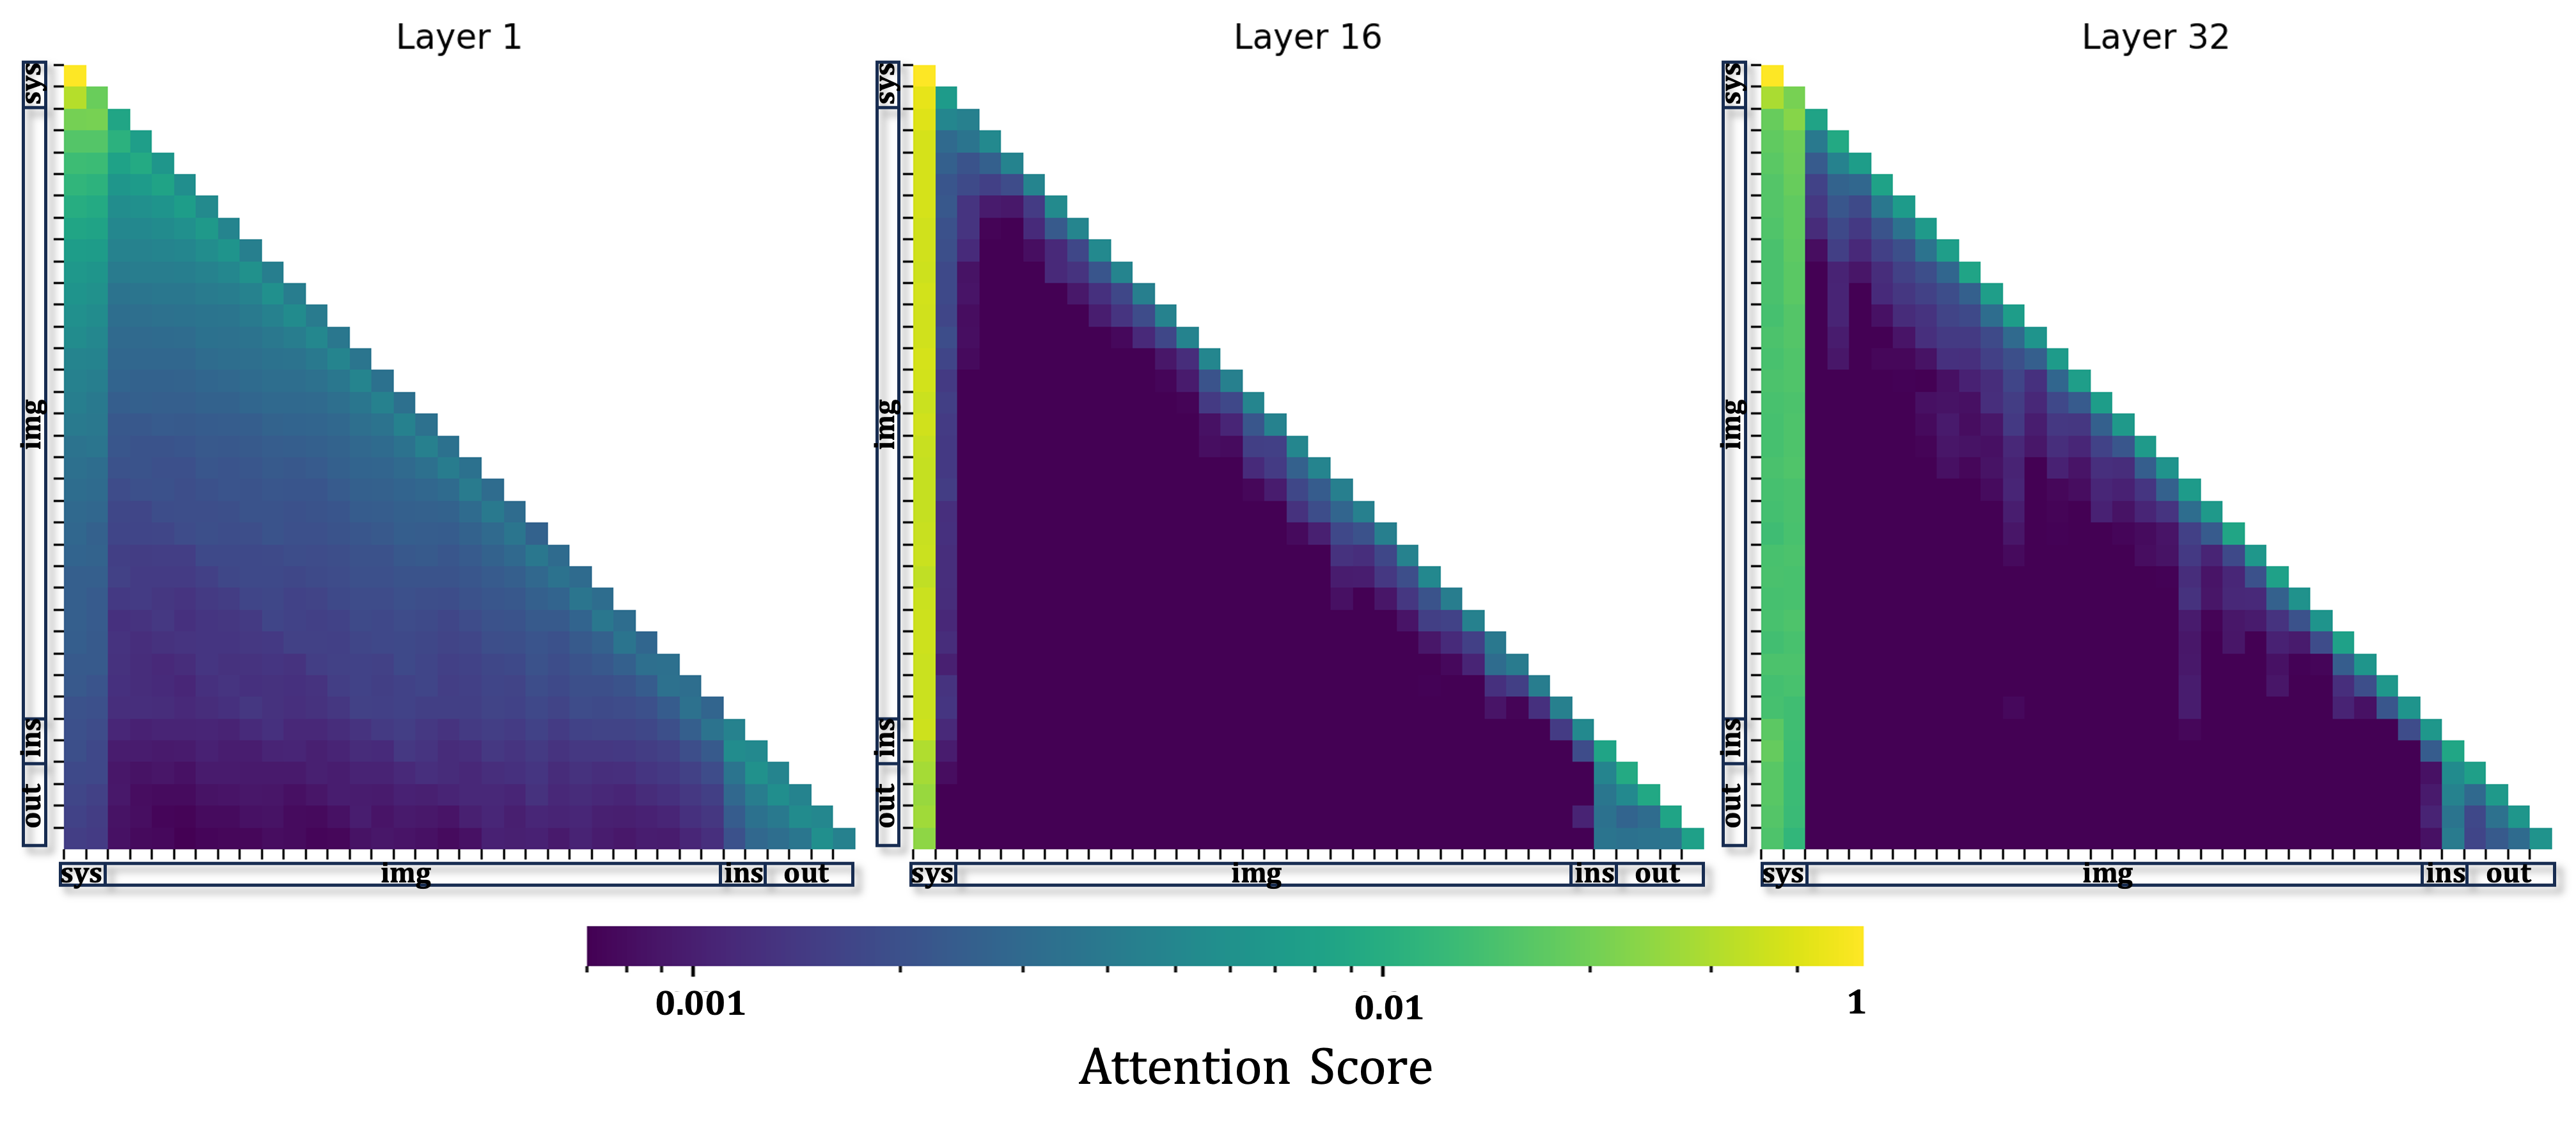
论文在 LLaVA-1.5-13B 等实验中展示了第 2 层之后剪除一半视觉 token、平均任务表现基本保持的配置,并报告约 45% 的理论 FLOPs 降幅。这是特定模型与评测设置的结果,不是所有 VLM 的默认安全阈值,更不是端到端耗时必然减少 45%。
还有一个实现陷阱:把 token 遮住,与真正缩短张量不是一回事。 如果只是修改 attention mask,后面的投影和 FFN 仍可能处理完整长度。官方仓库区分了掩码实验与实际 token dropping;测速度时必须确认运行的是哪种路径。官方实现说明
五、DiffRate:学习每层应该压缩多少
DiffRate 的全称是 Differentiable Compression Rate,由 Mengzhao Chen 等人提出,发表于 ICCV 2023。它的重点是把原来手动设置的逐层压缩率,转化为能用梯度优化的变量。会议论文页
它通过可微离散代理(Differentiable Discrete Proxy,DDP),在任务目标与计算预算约束下搜索剪枝、合并的压缩率。论文采用的组合是先剪枝、再合并:先去掉低重要性 token,再将部分剩余 token 与相似表示聚合。各层可以有不同的压缩配置,并不是预设一个“浅层合并、深层剪枝”的切换点。论文方法部分
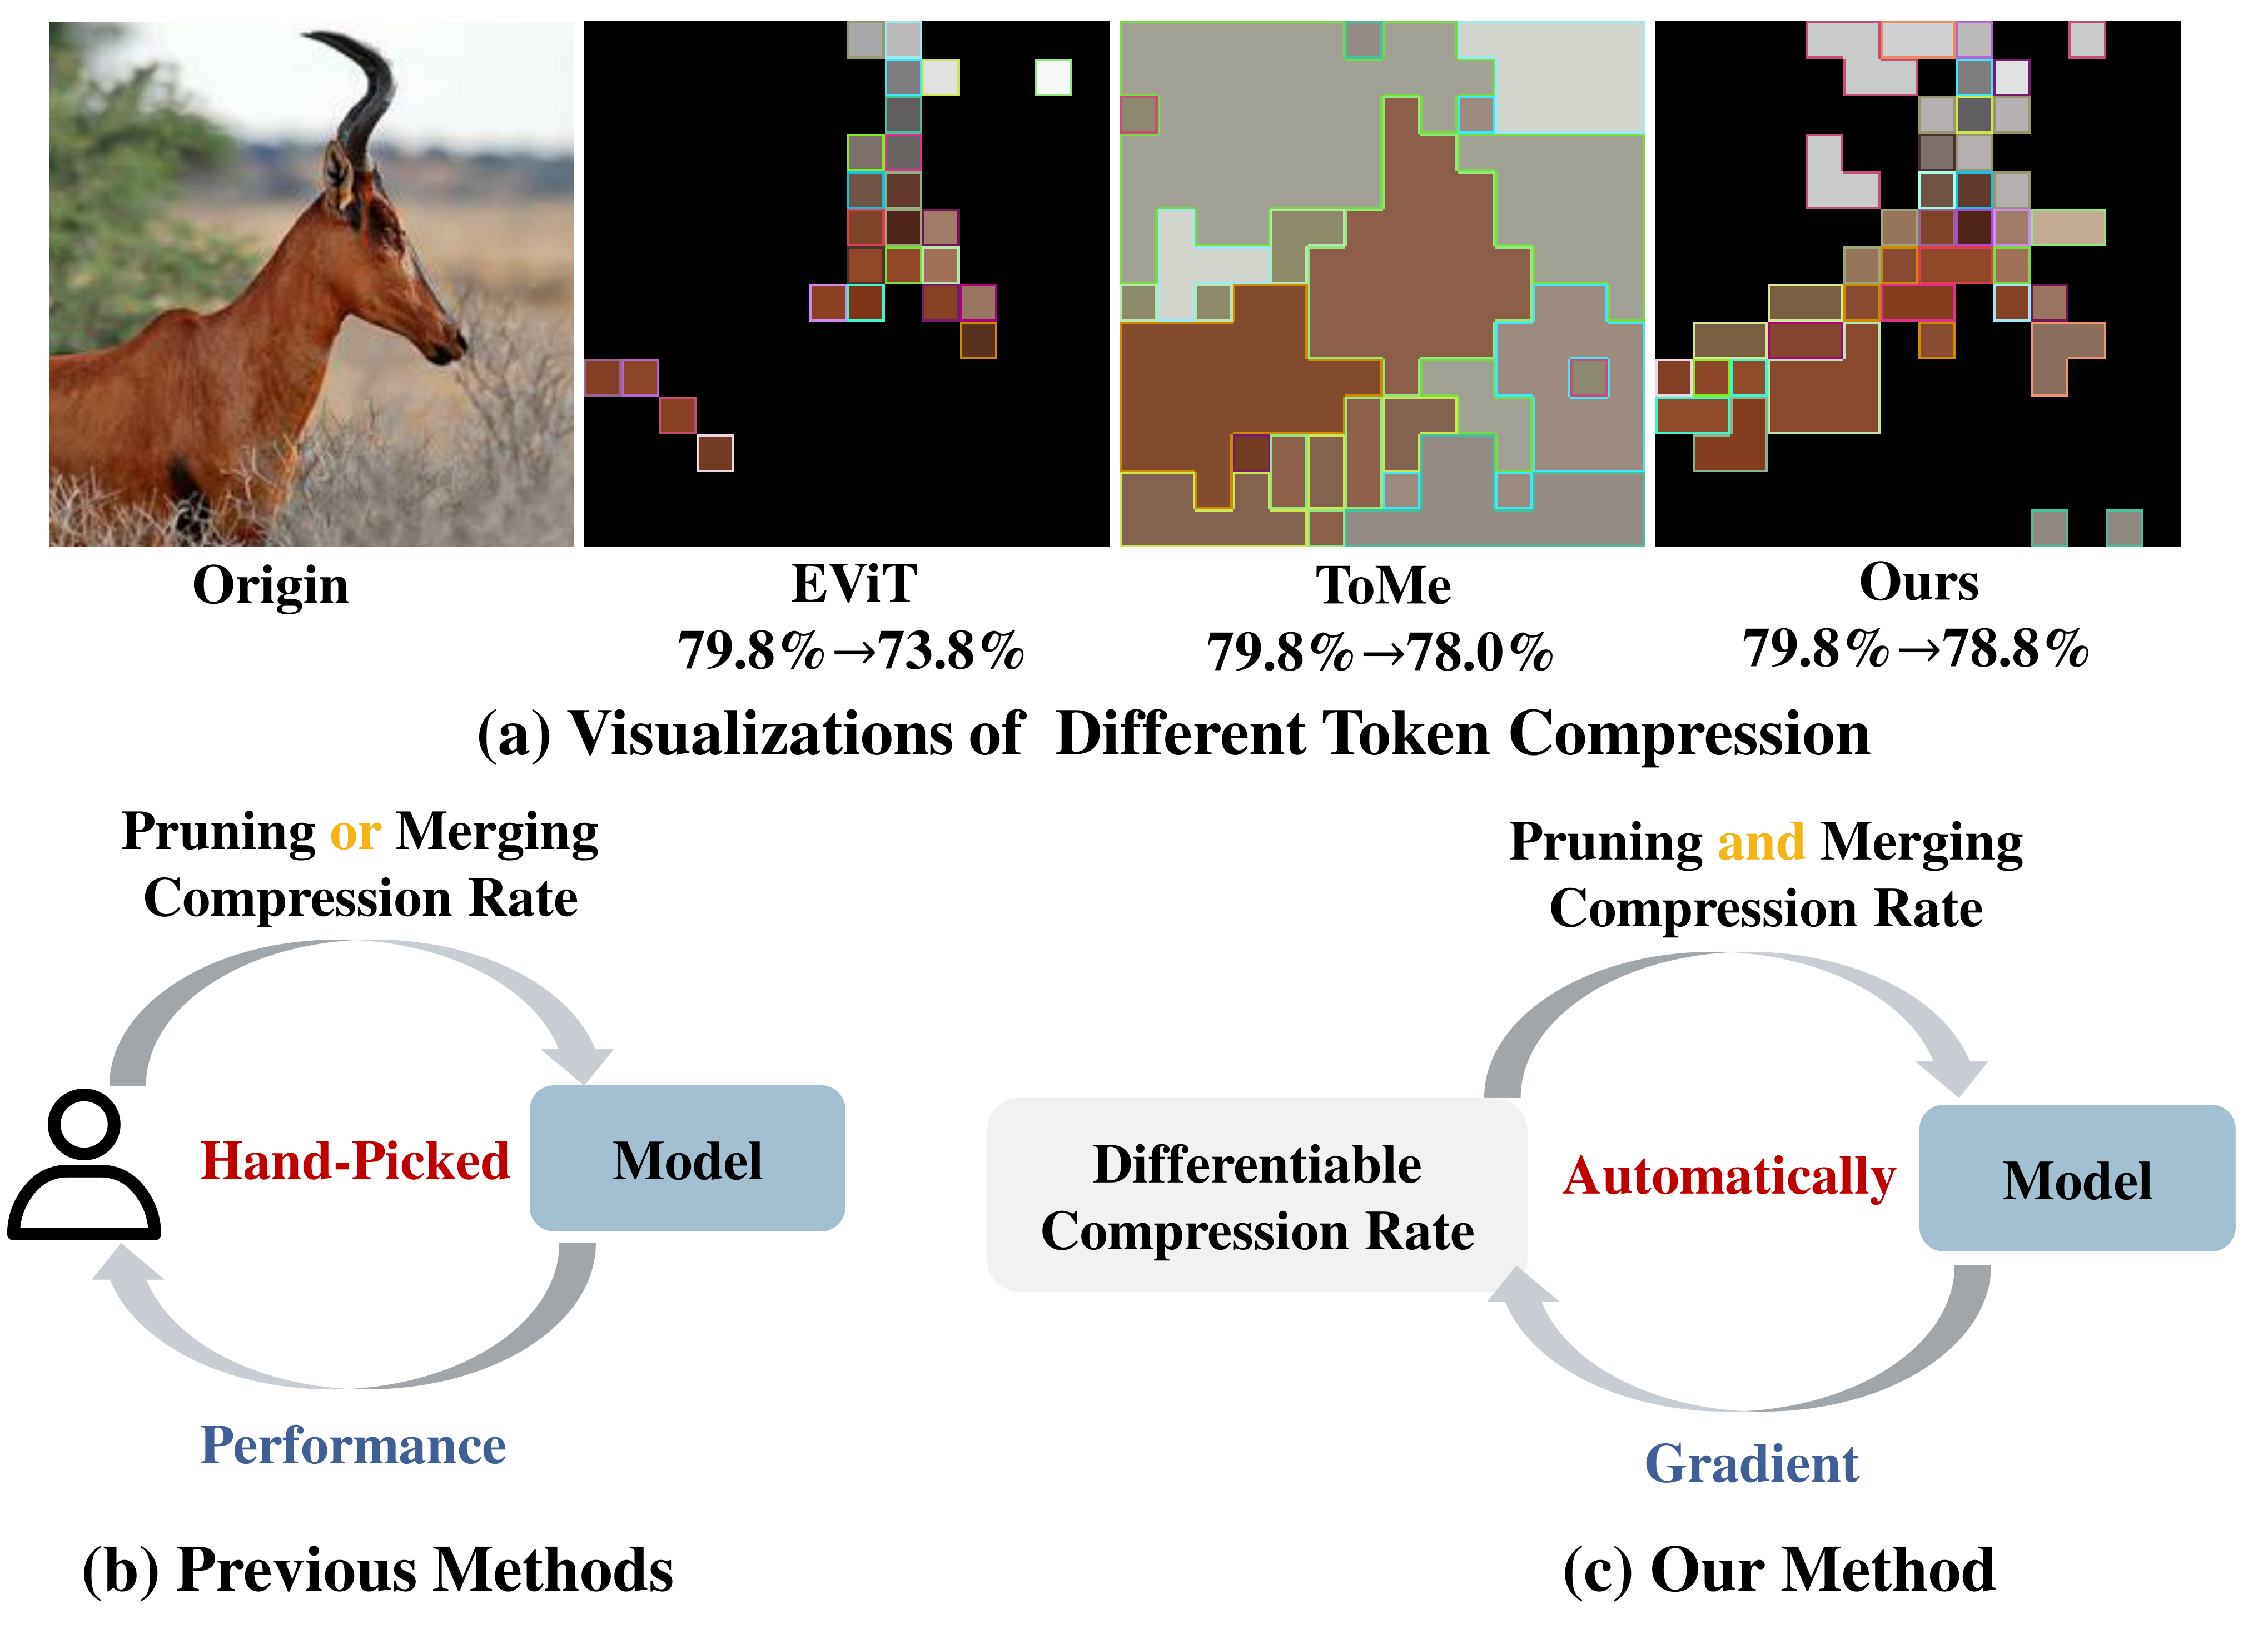
“不微调骨干权重”与“完全不需要搜索”也要区分。DiffRate 可以将搜索出的逐层压缩率用于已有模型,官方提供了可加载的配置;但得到这些配置本身需要优化过程。官方使用说明
例如原论文报告:在 ViT-H(MAE)上,特定配置降低约 40% FLOPs、提升约 1.5 倍吞吐,ImageNet 准确率下降约 0.16 个百分点。这组数字用于说明方法的实验结果,不能与 FastV 的 LLM 剪枝开销直接比较。
六、压缩一半 token,为什么不等于快四倍
对长度为 N、隐藏维度为 d 的序列,完整自注意力的交互计算包含 O(N²d) 项,但线性投影与前馈网络还包含随 N 线性增长的计算。模型权重占用、图像预处理和数据搬运也不会随着 token 减半而全部减半。FastV 的计算量分析
用一个简单的推导说明:若 LLM 输入有 784 个视觉 token、100 个文本 token,视觉 token 减半后,总长度从 884 变成 492。
注意力交互项比例 ≈ (492 / 884)² ≈ 31%
随序列长度线性变化的项比例 ≈ 492 / 884 ≈ 56%
这只描述压缩后相关层的理论比例。压缩前的层已经花掉的计算、排序或合并本身的开销,以及生成阶段的行为,都还没有计入。
特别是使用 KV cache 的自回归解码,每一步只增加少量新 token,不能把整段预填充的平方复杂度原样套到每一步生成。对于 VLM,应分别测量视觉编码耗时、prefill、首 token 延迟和后续生成速度,而不是只给出一个“提速百分比”。
七、实际接入时,先做小规模对照实验
从这些方法得到的工程启发,不是“永远删背景”或“统一在第 2 层压缩”,而是让压缩策略与模型、任务、硬件共同匹配。
- 确定瓶颈位置。 ViT 内压缩与 LLM 内剪枝作用不同。先测耗时分布,再决定在哪一段做实验。
- 扫描压缩率与层位置。 越早压缩,潜在节省越多,细节风险也可能越大;不存在对所有骨干通用的“总层数三分之一处最佳”。
- 建立细粒度测试集。 除了总体问答成绩,还要测试小字 OCR、计数、细小目标、空间关系,以及同图不同问题。
- 核对真实执行路径。 确认张量长度确实变短,并检查位置索引、attention mask、KV cache 和批处理是否仍然一致。
- 记录完整条件。 固定硬件、精度、batch size、分辨率、输出长度与注意力实现,同时报告延迟、吞吐、峰值显存和质量变化。
一个直观的失败测试是:先问“桌上是什么”,再问“杯子上的标签写了什么”。两次都能认出杯子,并不代表压缩后仍能读清标签。只看平均分,很容易漏掉这类局部能力下降。
总结起来,EViT 用重要性选择与融合重组织 token,ToMe 用相似度合并表示,FastV 将剪枝放到多模态 LLM 内部,DiffRate 则学习逐层的剪枝与合并预算。它们共同追求的不是 token 越少越好,而是在可接受的任务损失下,减少真正昂贵的后续计算。
参考资料
- EViT:Not All Patches are What You Need · 官方代码与配图
- ToMe:Token Merging: Your ViT But Faster · 官方代码与配图
- FastV:An Image is Worth 1/2 Tokens After Layer 2 · 官方代码与配图
- DiffRate:Differentiable Compression Rate for Efficient Vision Transformers · 官方代码与配图
- DynamicViT:Efficient Vision Transformers with Dynamic Token Sparsification
- Token Merging for Fast Stable Diffusion