“只有 4 张 A100,能不能把 13B 模型全参数微调跑起来?”这类问题,不能只看模型有多少参数,还得先算清楚训练时每张卡要保存多少东西。
标准数据并行会在每张 GPU 上复制一整套模型状态。ZeRO 的做法是把这些状态分片交给不同的数据并行进程管理,需要时再通信取回。它用通信换显存,是大模型训练中很常见的一种内存优化路线。
一、ZeRO 是什么
ZeRO 是 Zero Redundancy Optimizer 的缩写,中文常译为“零冗余优化器”。它由微软 DeepSpeed 团队提出:论文作者为 Samyam Rajbhandari、Jeff Rasley、Olatunji Ruwase 和 Yuxiong He,论文预印本于 2019 年提交,发表于 SC20(2020 年高性能计算、网络、存储与分析国际会议)。原论文 · SC20 论文信息
这里的“零冗余”不是说训练状态凭空消失,而是尽量避免数据并行的每张卡都保存同一份状态。ZeRO 逐级切分三类对象:优化器状态、梯度和模型参数。DeepSpeed 将这三步称为 ZeRO-1、ZeRO-2 和 ZeRO-3。DeepSpeed:ZeRO 官方教程
二、先算清楚显存账本
以下用一组常见的混合精度 Adam 训练假设估算:模型参数和梯度以 FP16/BF16 保存,优化器侧另有 FP32 主权重、Adam 一阶动量和二阶动量。每个参数对应的模型状态约为:
| 状态 | 每个参数占用 |
|---|---|
| 低精度模型参数 | 2 字节 |
| 低精度梯度 | 2 字节 |
| FP32 主权重 | 4 字节 |
| Adam 一阶动量 | 4 字节 |
| Adam 二阶动量 | 4 字节 |
| 合计 | 16 字节 |
所以,7B 参数模型仅模型状态就约需 7 × 10⁹ × 16 ≈ 112 GB。这是十进制近似值,而且还没有包括激活值、通信临时缓冲区、CUDA 上下文和显存碎片。ZeRO 主要切分模型状态,不会自动消除所有训练显存开销。
16 字节/参数是本文用于估算的典型混合精度 Adam 账本,不是所有训练配置的固定常数。精度、优化器、是否保留 FP32 主权重、框架实现等都会改变实际占用。
三、ZeRO 三阶段:每一步多切一类状态
下面的示意图来自 NVIDIA Megatron Core 文档,展示了数据并行基线以及 ZeRO 各阶段如何逐步切分参数、梯度和优化器状态。图中的 Ψ 是参数量,K 是每个参数对应的优化器状态字节数,Nd 是数据并行卡数。
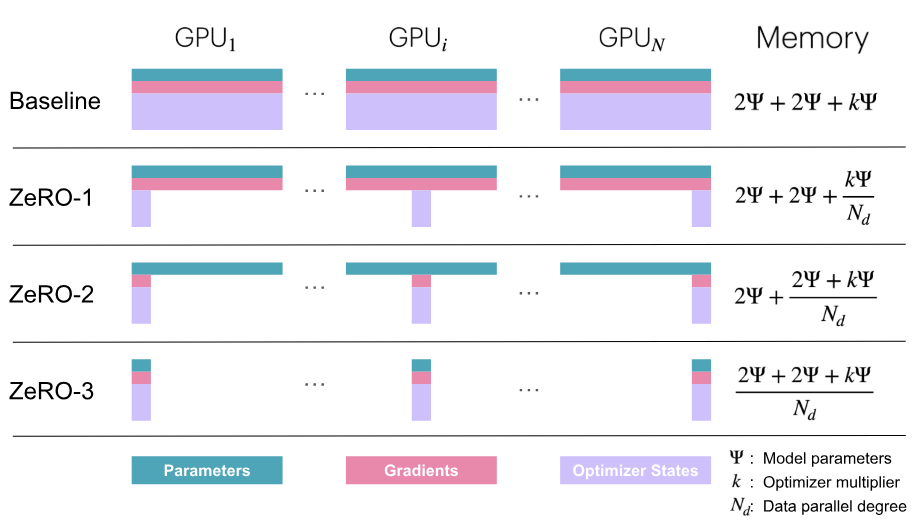
在上述 16 字节账本下,单卡上的模型状态可近似写成下面几条。令 N 为数据并行卡数:
普通数据并行:16 字节 × 参数量
ZeRO-1:       (4 + 12/N) 字节 × 参数量
ZeRO-2:       (2 + 14/N) 字节 × 参数量
ZeRO-3:       (16/N)     字节 × 参数量
ZeRO-1:切分优化器状态
ZeRO-1 只把优化器状态分到 N 张卡上:每张卡负责一部分 FP32 主权重和 Adam 动量,并更新自己负责的参数分片。模型参数和梯度仍然在每张卡上保留完整副本;一次更新结束后,各卡通过 AllGather 收集更新后的参数分片,恢复出完整参数。
它的每参数模型状态约为 4 + 12/N 字节。N 越大,优化器状态越薄;但完整参数和梯度这 4 字节仍然要每卡各存一份。因此“约 4 倍节省”是卡数很大时趋近的理论结果,不代表 8 张卡就正好只用原来的四分之一。
ZeRO-2:再切分梯度
ZeRO-2 在 ZeRO-1 的基础上,把梯度也按参数分片。反向传播时,通过 ReduceScatter 将规约后的梯度分给负责对应参数的进程;每张卡只保留自己那部分梯度,用它和本地优化器状态更新参数分片,然后再 AllGather 更新后的参数。
它的每参数模型状态约为 2 + 14/N 字节。参数副本仍完整保留,但梯度和优化器状态都只存一份分片。论文中的“约 8 倍”同样是 N 很大时的渐近上限;实际收益取决于数据并行卡数。
ZeRO-3:参数、梯度、优化器状态全切分
ZeRO-3 连模型参数本身也分片。每张卡平时只持有一部分参数;计算某层时,再按需收集该层需要的参数,完成计算后释放或重新分片。梯度和优化器状态也继续按参数分片。
理想化的模型状态占用约为 16/N 字节/参数,显存节省随数据并行规模线性增长。代价是参数需要在计算前后跨卡收集和分发,通信量更大;实际框架还会通过 bucket、预取和参数保留策略平衡显存与速度。
四、用 7B 模型算一遍:8 张卡并不等于除以 8
下面假设 7B 参数、混合精度 Adam、8 张数据并行 GPU,只比较模型状态:
| 方案 | 每参数模型状态 | 7B 模型每卡估算 | 说明 |
|---|---|---|---|
| 普通数据并行 | 16 字节 | 112 GB | 每卡保存完整状态 |
| ZeRO-1 | 5.5 字节 | 约 38.5 GB | 参数和梯度仍完整复制 |
| ZeRO-2 | 3.75 字节 | 约 26.25 GB | 参数完整复制,梯度和优化器状态分片 |
| ZeRO-3 | 2 字节 | 约 14 GB | 三类状态都分片 |
这些数字不是训练时的最终显存占用,激活值和通信缓冲区还要另外加上。比如 4 张 80GB A100 上训练 13B 模型,ZeRO-2 的模型状态估算约为 13 × (2 + 14/4) = 71.5 GB/卡,留给激活值、临时缓冲区和框架开销的空间可能不足;不能只凭这条公式保证任务能跑起来。ZeRO-3 的理想模型状态约为 52 GB/卡,但参数聚合产生的瞬时开销与通信成本也需要纳入实测。
一个常见误解是把 ZeRO-1 的“4 倍”、ZeRO-2 的“8 倍”直接套在任意卡数上。更准确的说法是:在本文这套 16 字节假设下,随着 N 增大,ZeRO-1 的模型状态占用趋近每参数 4 字节,ZeRO-2 趋近 2 字节;ZeRO-3 才是按 N 线性切分全部模型状态。原论文也把 4 倍、8 倍描述为大数据并行度下的节省上限。论文中的显存公式和示例
五、通信代价与适用场景
原论文的通信量分析中,ZeRO-1 和 ZeRO-2 的通信量与普通数据并行相同;ZeRO-3 因为需要额外收集参数,通信量约为基线的 1.5 倍。原论文通信分析
这里的 1.5 倍说的是论文设定下的通信量,不是承诺训练时间只慢 50%。实际速度还取决于 GPU 间互联、跨节点带宽、bucket 大小、计算与通信能否重叠、模型结构和批大小。跨节点网络较慢时,ZeRO-3 的额外通信尤其值得关注。
可以用下面的顺序做初选:
- 先试 ZeRO-1:优化器状态是主要瓶颈,希望尽量保持接近普通数据并行的通信模式。
- 再试 ZeRO-2:梯度也带来明显显存压力,想在状态切分和通信成本之间折中。
- 确有需要再上 ZeRO-3:参数副本本身也放不下,愿意接受更频繁的参数通信和配置调优。
如果 OOM 主要来自长序列、大 batch 的激活值,切分优化器状态未必能解决问题。这时还要考虑降低 micro-batch 或序列长度、使用 activation checkpointing,或配合 LoRA 等参数高效微调方法。
六、DeepSpeed 配置与 CPU Offload
在 DeepSpeed 集成中,ZeRO 阶段通过 JSON 配置启用。最小片段如下:
{
  "zero_optimization": {
    "stage": 2
  }
}
把 stage 改成 1 或 3 即可选择对应阶段。它是配置片段,不是完整训练配置;batch size、精度、优化器、通信 bucket 等仍要按所用训练脚本配置。DeepSpeed 官方教程给出了不同阶段的完整例子;使用 Hugging Face Trainer 或 Accelerate 时,也要按对应集成方式提供 DeepSpeed 配置。DeepSpeed ZeRO 教程 · Transformers DeepSpeed 文档
显存仍不足时,DeepSpeed 还支持把优化器状态卸载到 CPU;ZeRO-3 也可以进一步卸载参数,ZeRO-Infinity 还扩展到 NVMe。它们能借用主机内存和存储容量,但会带来 CPU-GPU 或存储传输开销,速度影响没有适用于所有机器的固定倍数,必须按目标设备测量。DeepSpeed 配置文档
总结
ZeRO 的三阶段可以记成一句话:ZeRO-1 切优化器状态,ZeRO-2 再切梯度,ZeRO-3 连参数一起切。 越往后,模型状态省得越多,参数通信也越重。
估算时先写清精度、优化器和数据并行卡数,再使用对应公式;最后还要给激活值、通信缓冲区和运行时开销留空间。ZeRO 能减少数据并行中的状态冗余,但它不是“把模型显存直接除以 GPU 数”的万能公式,也不替代对目标硬件的实际跑测。