你可能经常在多模态论文、开源仓库和模型排行榜里看到 LLaVA 这个名字。它看起来像一个模型,实际上更像是一套影响了整个开源视觉语言模型领域的“训练范式”:用一个现成的视觉编码器看图,用一个现成的大语言模型理解文字,再用一个不算复杂的连接器把两边接起来,最后用视觉指令数据把系统训练成一个能对话的助手。
这套方案为什么会有这么大的影响力?LLaVA 到底做了什么,后来的模型又继承了它的哪些想法?另外,LLaVA 资料里经常出现的 GQA 又是什么?
先给结论:LLaVA 最重要的贡献,不是发明了一个特别复杂的视觉模块,而是证明了“视觉编码器 + 简单投影层 + LLM + 视觉指令微调”可以用公开数据做出非常强、容易复现的开源多模态基线。
一、LLaVA 到底是什么
LLaVA 的全称是 Large Language and Vision Assistant,中文可以理解成“大型语言与视觉助手”。它最初来自 2023 年的论文 Visual Instruction Tuning,作者团队来自威斯康星大学麦迪逊分校、微软研究院等机构。论文、训练脚本和模型说明可以在 LLaVA 官方仓库 中找到。
它的基本结构其实很直白:
- 用一个视觉编码器把图片转换成一串视觉特征;
- 用一个投影层把视觉特征映射到语言模型的输入维度;
- 把视觉 token 和文字指令一起交给 LLM;
- 让 LLM 自回归地生成回答。
原始 LLaVA 选择了预训练的 CLIP ViT-L/14 作为视觉编码器,选择 Vicuna 作为语言模型,中间只放了一个可训练的线性投影层。设图片为 ,视觉编码器为 ,投影矩阵为 ,那么视觉 token 可以写成:
其中 是视觉编码器输出的 patch 特征, 是已经被映射到 LLM 词向量空间的视觉表示。它们仍然是连续向量,不是“图片先被翻译成了几个中文词”。LLM 接收到的更像是一串特殊的视觉 token,再加上一句文本指令。
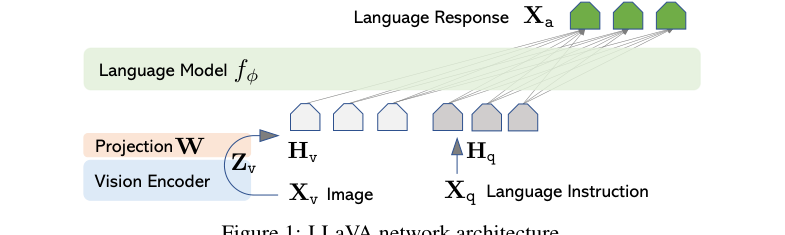
这里最关键的不是投影层有多复杂,而是它承担了一个接口适配任务:CLIP 的视觉特征空间和 Vicuna 的文本嵌入空间维度不同、分布不同,需要先学会“说同一种表示语言”。
二、LLaVA 为什么不直接把图片送给 LLM
语言模型并不能直接读取像素。对它来说,一张 的图片不是一句话,而是一个三维像素张量。视觉编码器先把图片切成 patch,再通过 ViT 提取每个 patch 的上下文特征。
以 CLIP ViT-L/14 为例:
- 输入分辨率为 时, 的 patch 网格会产生 个视觉位置;
- 输入分辨率为 时,会产生 个视觉位置;
- 这些位置经过投影层后,通常作为一串视觉 token 拼到文本 token 前面或指定位置。
所以 LLaVA 的“看图”不是先运行一个目标检测器,输出“猫、沙发、杯子”这几个标签,再让语言模型写答案。它保留了更密集的 patch 级表示,让后面的语言模型自己在指令约束下组织视觉证据。
当然,这也带来一个代价:视觉 token 越多,LLM 的上下文长度和注意力开销越大。后来 LLaVA-NeXT、LLaVA-1.5-HD 以及很多高分辨率 VLM,都会继续处理“细节能力”和“视觉 token 数量”之间的矛盾。
三、LLaVA 的两阶段训练
原始 LLaVA 的训练并不是把所有模块从零一起训练,而是分成两个阶段。
第一阶段:特征对齐
第一阶段的目标是让视觉特征能够被语言模型理解。官方仓库将这一阶段描述为 feature alignment stage:
- 使用约 558K 图文对,来自 LAION-CC-SBU 的子集;
- 视觉编码器冻结;
- 语言模型冻结;
- 只训练视觉到语言的投影层。
这个阶段解决的是“接口问题”。如果视觉编码器说的是一种向量语言,LLM 说的是另一种向量语言,那么投影层要先学会把前者翻译成后者。它并不负责让模型立刻学会复杂的多轮对话。
第二阶段:视觉指令微调
第二阶段才是真正让模型变成“助手”的过程。LLaVA 团队利用文本版 GPT-4,根据图片描述、目标框和已有标注生成多模态指令数据,主要包含三类:
- Conversation:围绕图片进行多轮问答;
- Detailed description:要求模型详细描述图片内容;
- Complex reasoning:需要整合多个物体、属性或空间关系进行推理。
这批数据通常被称为 LLaVA-Instruct-150K。论文正文统计的独立样本约为 158K,其中约 58K 是对话、23K 是详细描述、77K 是复杂推理。这里“150K”和“158K”并不矛盾:前者是数据集的常用名称,后者是论文中的具体统计口径。
这一阶段的训练目标仍然是普通的语言模型 next-token prediction:给定图片、用户指令和历史对话,让模型只对助手回答部分计算语言建模损失。换句话说,LLaVA 没有为每一种视觉任务额外设计一套损失,而是把多种视觉任务包装成“看图后回答”的统一格式。
这一步影响很大。它把传统的图像描述、视觉问答、空间推理,统一成了语言模型最熟悉的指令跟随问题。
四、GQA 数据集是什么
现在回到最容易混淆的 GQA。
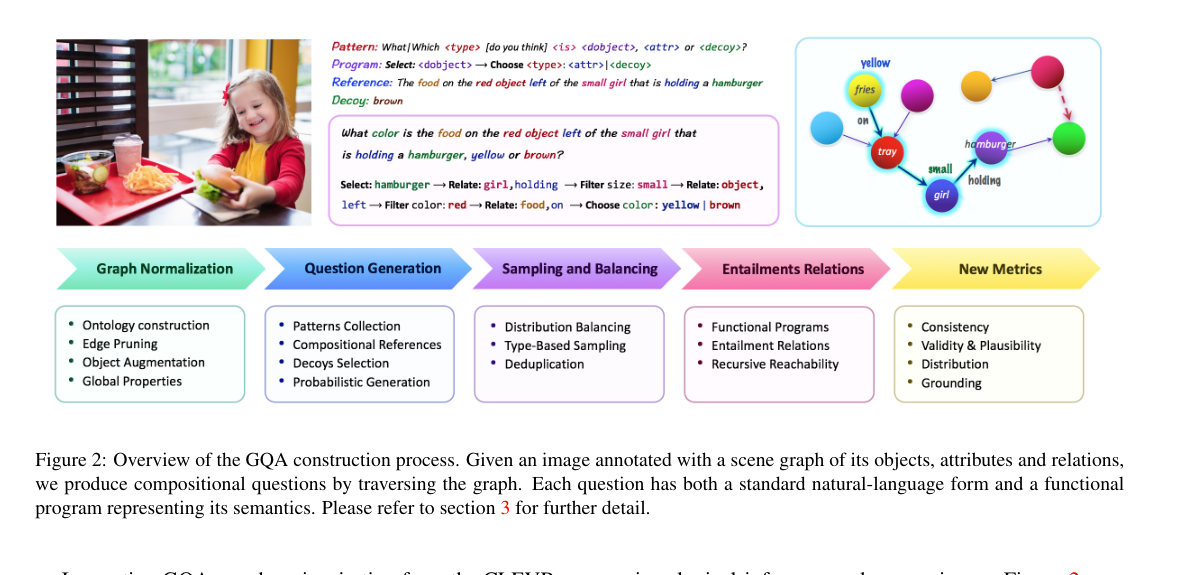
GQA 数据集由 Drew Hudson 和 Christopher Manning 在 2019 年提出,论文标题是 GQA: A New Dataset for Real-World Visual Reasoning and Compositional Question Answering。它不是一个模型,也不是 LLaVA 发明的数据集。
GQA 建立在 Visual Genome 的场景图之上。场景图会记录图片里有哪些物体、每个物体有什么属性,以及物体之间有什么关系。例如:
- 一个女孩;
- 女孩手里拿着汉堡;
- 汉堡在托盘上;
- 托盘旁边有薯条;
- 女孩穿着什么颜色的衣服。
然后,GQA 沿着这些对象、属性和关系生成自然语言问题,并为每个问题保留一个表示推理步骤的 functional program。这样,模型不只是回答“图片里有什么”,还要完成选择对象、查找关系、过滤属性、比较和组合推理。
数据规模也很大:GQA 论文统计了约 113K 张图片、约 22.7M 个问题,覆盖物体识别、属性识别、关系追踪、空间推理、逻辑推理和比较等能力。
因此,在 LLaVA 官方仓库里看到类似下面的内容时:
GQA: images
OCR-VQA: images
TextVQA: images
Visual Genome: images
这里的 GQA 指的是要下载图片、准备标注或运行评测的 GQA 数据集。LLaVA-1.5 的训练数据混合中也加入了 GQA、OCR-VQA、TextVQA、Visual Genome 等偏学术任务的数据。
那 GQA 注意力又是什么
另一种 GQA 是 Grouped-Query Attention,由 Joshua Ainslie 等人在 2023 年的论文 GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints 中系统研究。
它讨论的是 Transformer 内部的 Query、Key、Value 如何共享:
- MHA,Multi-Head Attention:每个 query head 都有自己的 key/value head;
- MQA,Multi-Query Attention:所有 query head 共享一组 key/value;
- GQA,Grouped-Query Attention:把 query head 分成若干组,每组共享一个 key/value head。
GQA 的目标是减少自回归生成时 KV cache 的显存和带宽压力,同时尽量保留 MHA 的效果。它主要影响 LLM 的推理效率,并不负责从图片中生成 GQA 数据集的问题。
一句话区分:
| 你看到的位置 | GQA 的含义 |
|---|---|
| LLaVA 数据准备、训练集、评测集 | GQA 视觉推理数据集 |
模型配置、num_key_value_heads、KV cache | Grouped-Query Attention |
五、LLaVA-1.5 做了什么
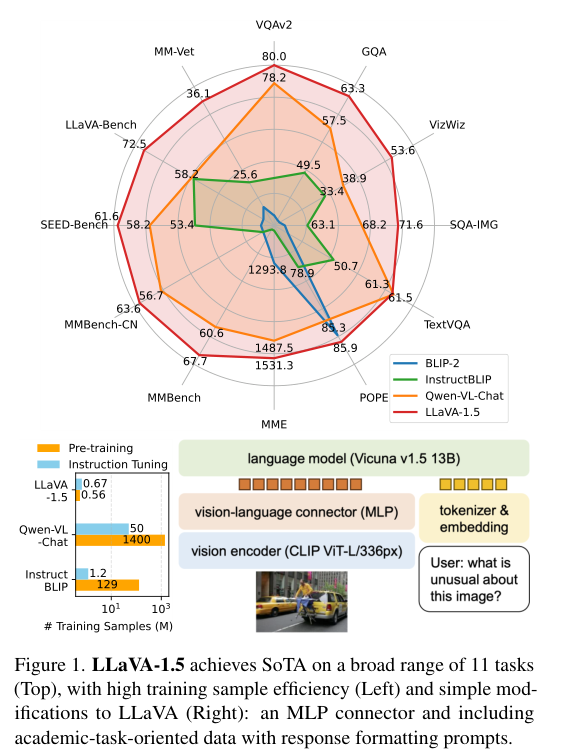
原始 LLaVA 证明了范式可行,但它的视觉分辨率、连接器和训练数据还比较朴素。2023 年的 Improved Baselines with Visual Instruction Tuning 提出了 LLaVA-1.5,后来发表于 CVPR 2024。
LLaVA-1.5 的改进并不神秘,主要有三件事:
- 将视觉编码器换成更高分辨率的 CLIP ViT-L/14-336px;
- 将简单线性投影换成两层 MLP 连接器;
- 加入更多面向学术任务的 VQA 数据,并调整回答格式和数据混合方式。
官方训练脚本里可以看到类似 openai/clip-vit-large-patch14-336 和 mlp2x_gelu 的配置。也就是说,LLaVA-1.5 并不是彻底推翻原来的架构,而是在原始框架上把输入分辨率、连接器表达能力和训练数据补齐。
论文摘要报告称,LLaVA-1.5 在 11 个多模态基准上取得了很强的结果,13B 版本使用约 1.2M 条公开数据,在一个 8 张 A100 的节点上大约一天完成训练。这个结果让很多人意识到:开源多模态模型的差距,不一定只来自参数规模,也来自视觉分辨率、数据配方、答案格式和训练流程。
六、LLaVA 的影响力到底在哪里
LLaVA 的影响力可以分成“直接的模型家族”和“被整个领域吸收的训练方法”两部分。
1. 它建立了一个可复用的开源基线
在 LLaVA 之前,多模态模型也有视觉编码器、语言模型和跨模态模块,但不少系统训练数据、模型权重或完整训练流程并不容易复现。LLaVA 把这条链路拆得很清楚:
每个模块都可以替换。你可以更换 CLIP,换成 SigLIP;可以把线性层换成 MLP、Q-Former 或其他 resampler;也可以把 Vicuna 换成 LLaMA、Mistral、Qwen 等语言模型。这个模块化接口后来几乎成了开源 VLM 工程的共同语言。
2. 它把“视觉指令微调”变成主流路线
LLaVA 最有影响力的词可能不是模型名,而是 Visual Instruction Tuning。它把图片、问题和回答组织成类似聊天的数据,然后使用语言模型已有的指令跟随能力来学习视觉任务。
后续很多系统都采用了类似的思路:
- 先用图文对或视觉特征对齐,让模型“接上视觉输入”;
- 再用多模态指令数据,让模型学会按人的方式回答;
- 最后混合 VQA、OCR、科学问答、图表理解、视频问答等任务,提高泛化能力。
这里不代表所有后续模型都是 LLaVA 的直接分支。像 BLIP-2、InstructBLIP、Qwen-VL、InternVL 等都有自己的视觉模块和数据配方,但“视觉编码器 + 语言模型 + 跨模态连接器 + 指令微调”这一问题拆解方式,已经成为共同的研究框架。
3. 它直接催生了一批扩展工作
| 工作或方向 | 继承或扩展了 LLaVA 的什么 |
|---|---|
| LLaVA-1.5 | 在同一框架上改进分辨率、MLP 连接器和学术 VQA 数据 |
| LLaVA-NeXT / LLaVA-1.6 | 继续提高分辨率、支持更强的语言模型和更复杂的视觉输入 |
| LLaVA-OneVision | 将统一的视觉指令模型扩展到单图、多图和视频场景 |
| Video-LLaVA | 把 LLaVA 式视觉语言对齐思路扩展到视频 token |
| LLaVAR | 在 LLaVA 框架上加入更强的 OCR 和文本丰富图像能力 |
| MobileVLM、VILA 等开源模型 | 在轻量化、数据混合和高效部署方向复用相似的模块化范式 |
更准确地说,LLaVA 的“影响”通常不是某个后续模型复制了它的每一行代码,而是它提供了一种大家都能快速改造、训练和比较的公共基线。
4. 它改变了多模态研究的比较方式
LLaVA 之后,论文里更常见的不只是“模型有多少参数”,还会比较:
- 视觉编码器选什么、分辨率是多少;
- 视觉 token 保留多少;
- 连接器是线性层、MLP、Q-Former 还是 cross-attention;
- 对话数据、OCR 数据、学术 VQA 数据如何混合;
- 训练时冻结哪些模块;
- 模型在 GQA、TextVQA、OCR-VQA、ScienceQA、MMBench、MM-Vet 等任务上的表现。
这套比较框架让多模态模型的改进更容易被拆解:究竟是视觉前端更强,连接器更好,数据更丰富,还是语言模型本身更强。
七、LLaVA 没有解决什么
LLaVA 的影响力很大,但不能把它理解成“只要接上视觉编码器,LLM 就真正看懂了图片”。它仍然有几类明显限制:
第一,细粒度定位和 OCR 不是它的强项。 视觉 token 是 patch 级的,图片中文字很小、物体边界很细时,输入分辨率和 patch 数量会直接限制能力。
第二,视觉 token 会挤占语言上下文。 分辨率升高后,视觉 token 可能从几百个增加到上千个。模型看得更细,但显存、延迟和上下文长度也会一起上涨。
第三,回答流畅不等于证据可靠。 LLM 可能利用语言先验生成一个听起来合理的答案,却没有真正从图片中找到对应证据,这就是常说的视觉幻觉。
第四,GQA 分数不等于通用视觉推理。 GQA 主要检验组合式视觉问答;OCR、图表、视频、空间定位和机器人控制还需要其他数据和评测。不能看到一个基准分数高,就推断模型已经具备所有视觉能力。
所以,LLaVA 更适合被理解为一个非常成功的开源多模态训练起点,而不是视觉理解问题的最终答案。
八、把一张图片送进 LLaVA 时,内部发生了什么
以“这张图里有什么不寻常的地方?”为例,流程可以压缩成下面几步:
- 图片进入 CLIP ViT,得到一串 patch 特征;
- Projector 把每个视觉特征映射到 LLM 的隐藏维度;
- 图像 token 和用户文本一起组成上下文;
- LLM 根据训练中学到的视觉指令模式,逐 token 生成回答;
- 生成下一个 token 时,模型会同时利用视觉 token、问题 token 和已经生成的回答。
它不是“视觉模型先给出结论,语言模型再把结论润色一下”。更接近的理解是:视觉编码器提供一组可被语言模型读取的证据,语言模型在指令和上下文约束下组织这些证据。
这也是为什么连接器虽然只有一层或两层,却非常关键:连接器决定了 LLM 能不能把视觉特征当成有意义的上下文来使用。
九、一分钟总结
LLaVA 是一个开源视觉语言模型,也是一个影响很大的训练范式:
- 架构上:视觉编码器提取 patch 特征,Projector 映射到语言空间,LLM 负责理解指令并生成回答;
- 训练上:先做图文特征对齐,再做视觉指令微调;
- 数据上:用 GPT 生成对话、详细描述和复杂推理数据,再混合 GQA、TextVQA、OCR-VQA 等学术任务;
- 影响上:它把一个相对简单、公开、可复现的多模态基线带给了开源社区,直接推动了 LLaVA-1.5、LLaVA-NeXT、LLaVA-OneVision、Video-LLaVA 等一系列工作;
- 辨析上:LLaVA 资料中的
GQA大多是视觉推理数据集;模型配置里的GQA才通常是 Grouped-Query Attention。
如果你下一次再看到 “LLaVA + GQA”,先看它出现在哪个位置:在数据集列表里,它是在说“模型做过哪些视觉题”;在注意力配置里,它是在说“语言模型怎样节省 KV cache”。这两个 GQA,名字一样,作用完全不同。