“DETR 和 Faster R-CNN 有什么区别?”“为什么原始 DETR 训练那么慢?”“检测模型去掉 NMS 后,真的更容易部署吗?”这些问题串起了 DETR 系列的发展。理解这条技术线,需要同时看预测范式、训练监督、注意力计算与硬件效率。
一、DETR:把目标检测变成集合预测
Carion 等人在 ECCV 2020 提出 DETR(DEtection TRansformer):CNN 骨干提取图像特征,加入位置编码后送入 Transformer encoder;decoder 使用一组固定数量的可学习 object queries,输出类别和边界框。没有对应目标的预测被监督为 “no object”。
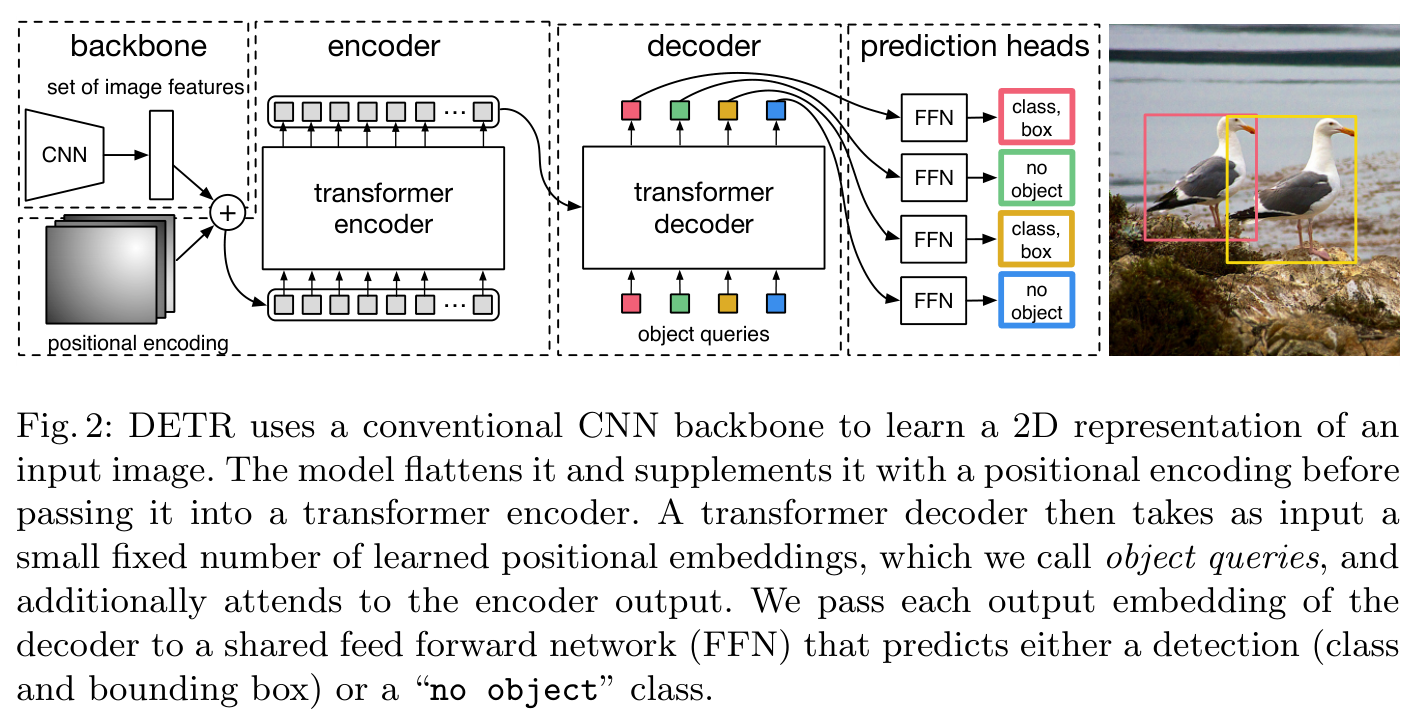
训练时,匈牙利算法寻找预测与真实目标之间的最优一对一匹配。简化写法是:
匹配代价结合类别与框的位置关系;确定对应关系后,再计算分类、L1 框回归和 GIoU 等损失。匹配代价和训练损失的权重不必完全一致。
这种集合监督促使模型为每个物体产生一个有效预测,因此推理不依赖 NMS。但仍需要分数筛选、坐标转换等操作,也不能保证永远没有重复框。相比常规 Faster R-CNN,DETR 移除了 RPN 和传统 anchor/NMS 流程,但保留了骨干与检测头。
原始 ResNet-50 DETR 在 COCO 上报告约 42.0 AP,代表性训练周期为 500 epoch。原文中的 39.9 AP 不宜当作其统一结果;不同表格、基线与训练配置需要分别核对。
二、为什么原始 DETR 收敛慢
初期 query 缺乏明确的空间位置,交叉注意力需要从大量特征位置中学习定位;匹配对象也会随着预测变化而改变。单尺度低分辨率特征对小目标不够友好,而 encoder 全局自注意力的复杂度随特征 token 数平方增长。
这里的 token 数指骨干输出特征的空间位置数,不是直接等于原图像素数。计算成本高与收敛慢相关,但并不是同一个问题。后续方法分别从稀疏采样、位置先验和稳定监督切入。
三、Deformable DETR:稀疏采样与多尺度
Zhu 等人的 Deformable DETR 发表于 ICLR 2021。它让 query 围绕参考点读取少量可学习采样位置,同时预测偏移与权重,替代对整个特征图的密集关注。
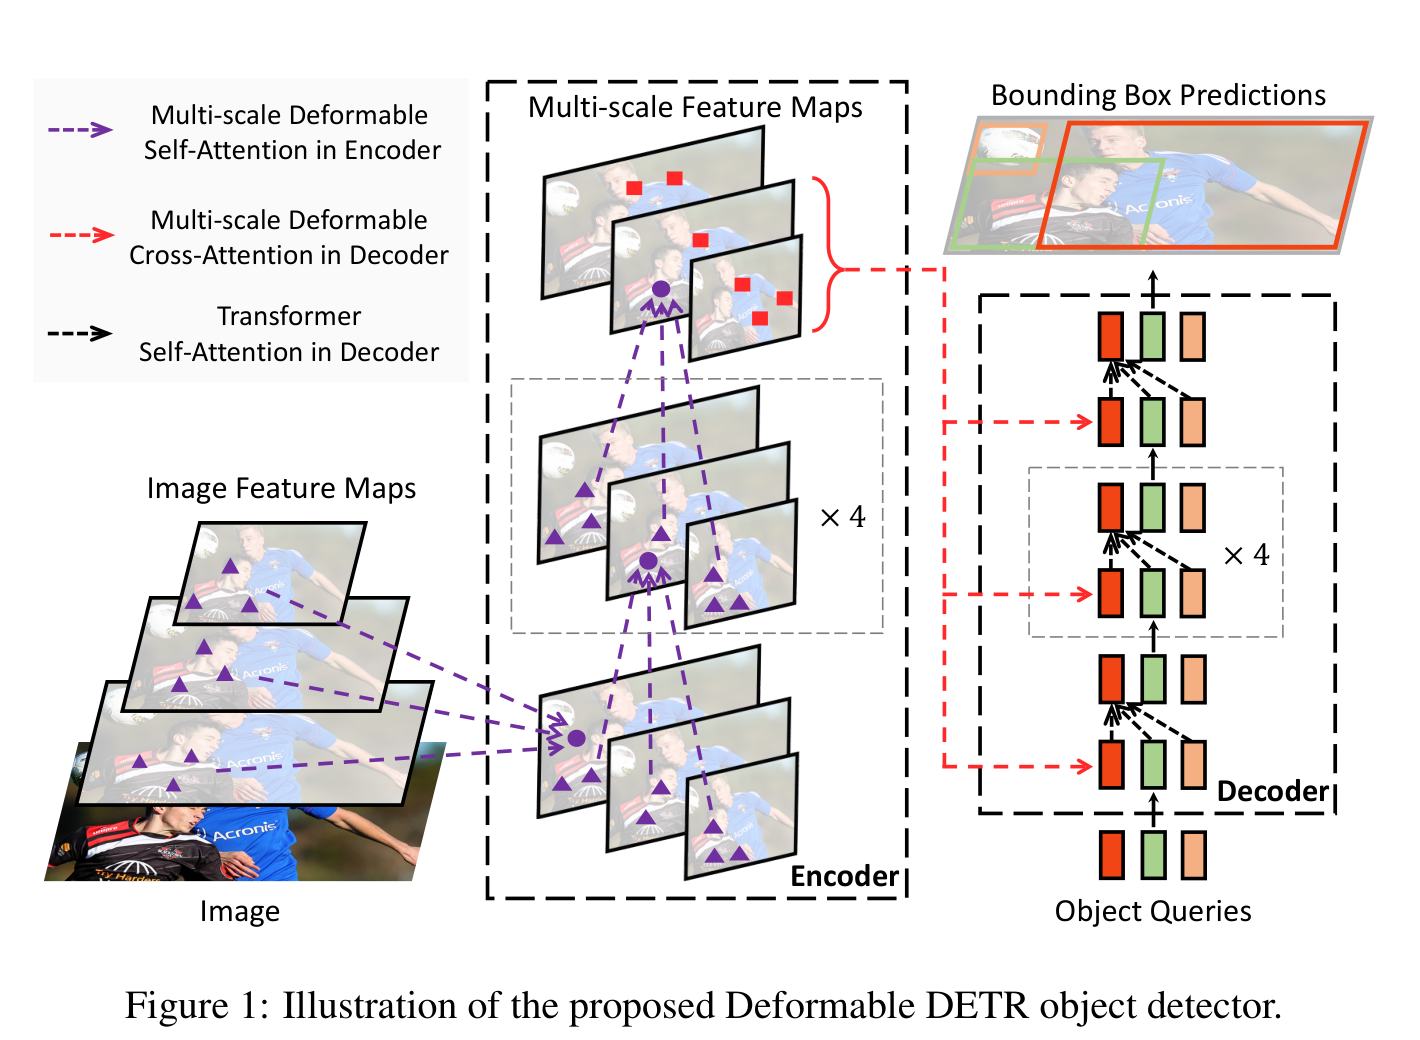
“采样 4 个点”通常要结合每个注意力头、每个特征尺度理解,不能把它理解成整个 query 总共只访问四个位置。模型在不同尺度上直接采样,不要求先构建传统 FPN 的完整自顶向下融合路径。
其典型训练周期缩短为 50 epoch,小目标性能也改善。论文中的基础配置与加入迭代框细化、两阶段 query 初始化的配置不同;约 46.2 AP 对应增强配置,不能把它与任意基础模型直接混用。
四、DAB-DETR:用动态锚框表达空间 query
DAB-DETR 发表于 ICLR 2022,把位置 query 表达为 动态锚框,并结合内容特征进行解码。框坐标参与位置编码,宽高还帮助调节注意力的空间范围。
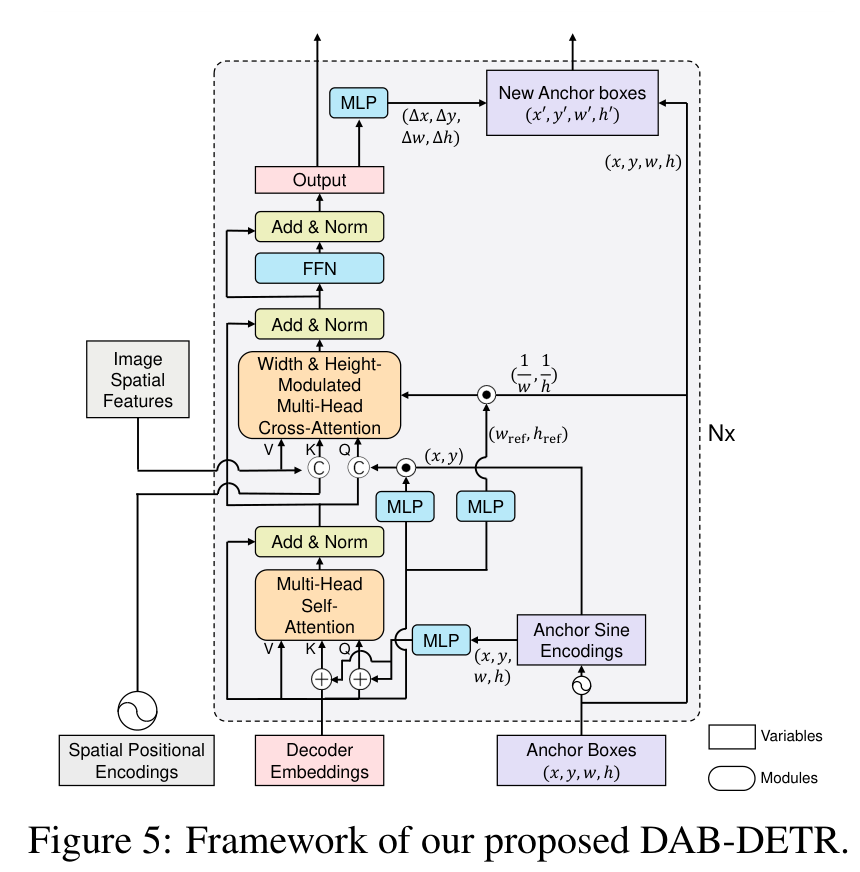
每层 decoder 都能细化框的位置和大小,为下一层提供空间参考。它并非把 query 的所有信息压缩成四个数:内容表示仍然存在。动态框也不同于传统检测器在每个特征位置铺设大量固定 anchor 的做法。
五、DN-DETR:已知对应关系的去噪监督
DN-DETR 发表于 CVPR 2022,在正常匹配 query 之外,用真实框和类别加入扰动,构造训练专用的去噪 query,让模型恢复原始目标。
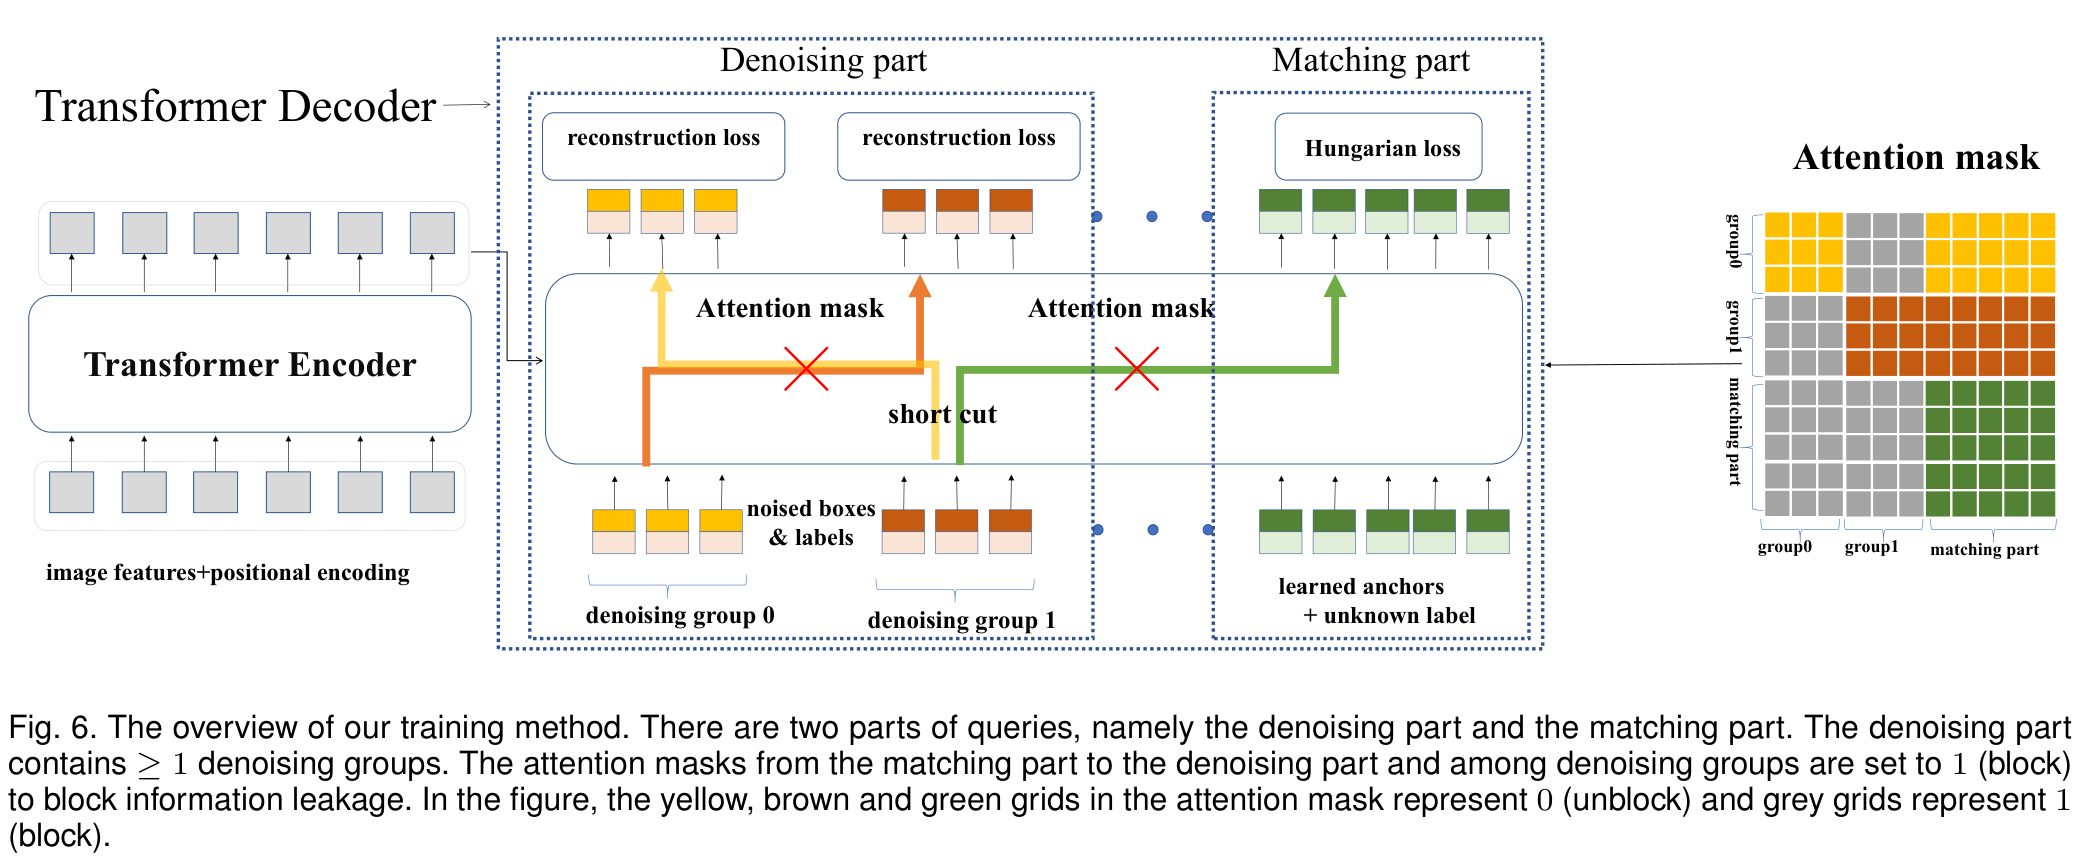
去噪目标的对应关系已知,不依赖当次匈牙利匹配,因此提供稳定的辅助监督。注意力掩码用于防止正常 query 读取真实标签信息,并控制去噪组之间的信息交流。
这些 query 只在训练阶段出现,推理时移除。收益取决于底层模型、噪声设置和训练周期,“提升 1.9 AP”不能作为所有配置的固定增益。
六、DINO:更好的初始化、去噪与框更新
检测领域的 DINO 发表于 ICLR 2023,与自监督视觉模型 DINO/DINOv2 不是同一种方法。它结合多尺度可变形注意力,并重点改进三个环节。
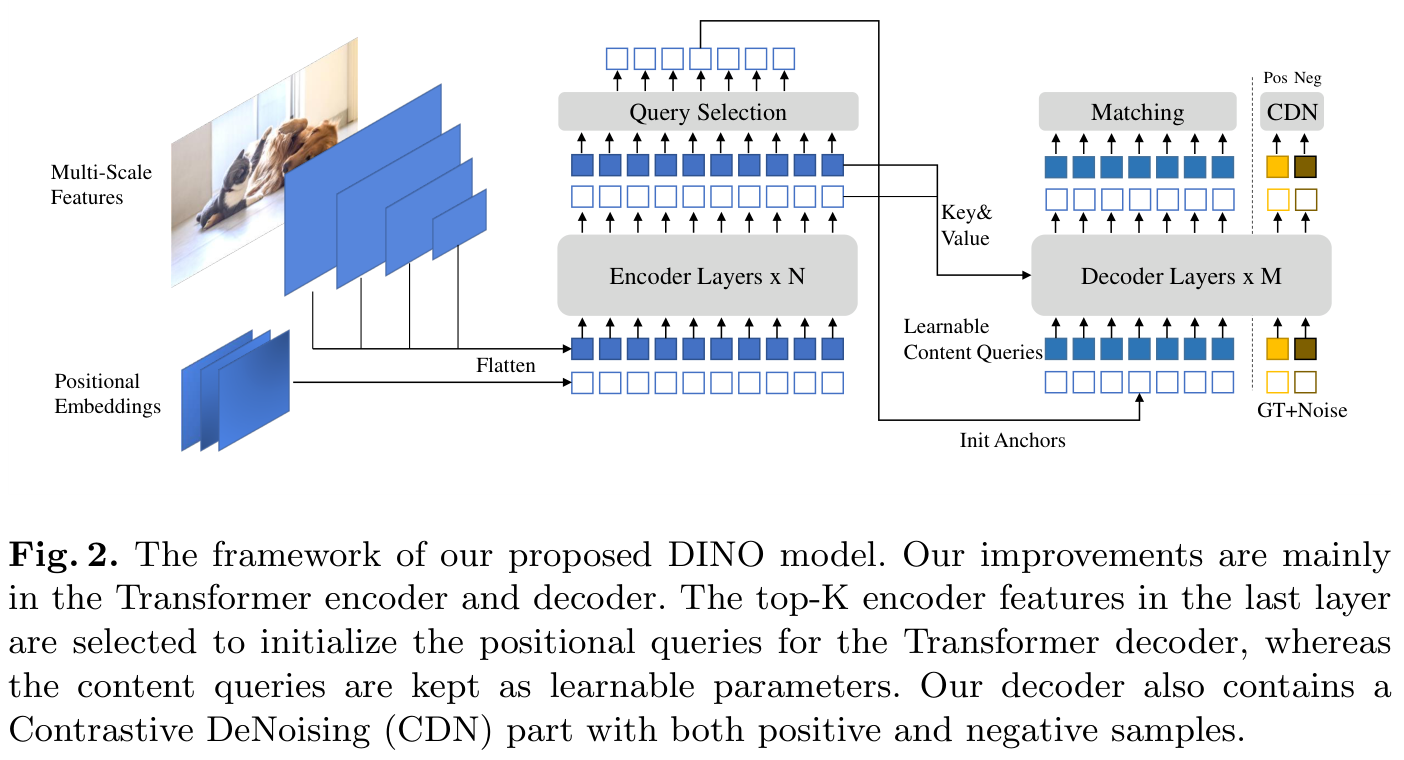
- 对比去噪:较小扰动的正样本恢复目标,较大扰动的负样本学习预测无物体,帮助抑制重复检测。
- 混合 query 选择:从 encoder 候选初始化位置 query,内容 query 保持可学习参数,而不是把两部分都直接复制候选特征。
- Look forward twice:调整跨层框细化中的梯度路径,使后续层监督能帮助前一层框更新。它不是当前层提前读取尚未计算的下一层特征。
论文报告 ResNet-50 配置在 12 epoch 达到 49.4 AP、24 epoch 达到 51.3 AP。特征层数、训练增强等设置仍须与原表格一起比较,不能仅凭 backbone 名称判断公平性。
七、RT-DETR:把端到端检测做成实时系统
百度团队的 RT-DETR 论文发表于 CVPR 2024。高效混合 encoder 将同尺度交互与跨尺度融合解耦:AIFI 在高层特征上做注意力交互,CCFF 使用卷积路径融合多尺度信息。它还设计不确定性最小化 query 选择,为 decoder 提供更好的候选。
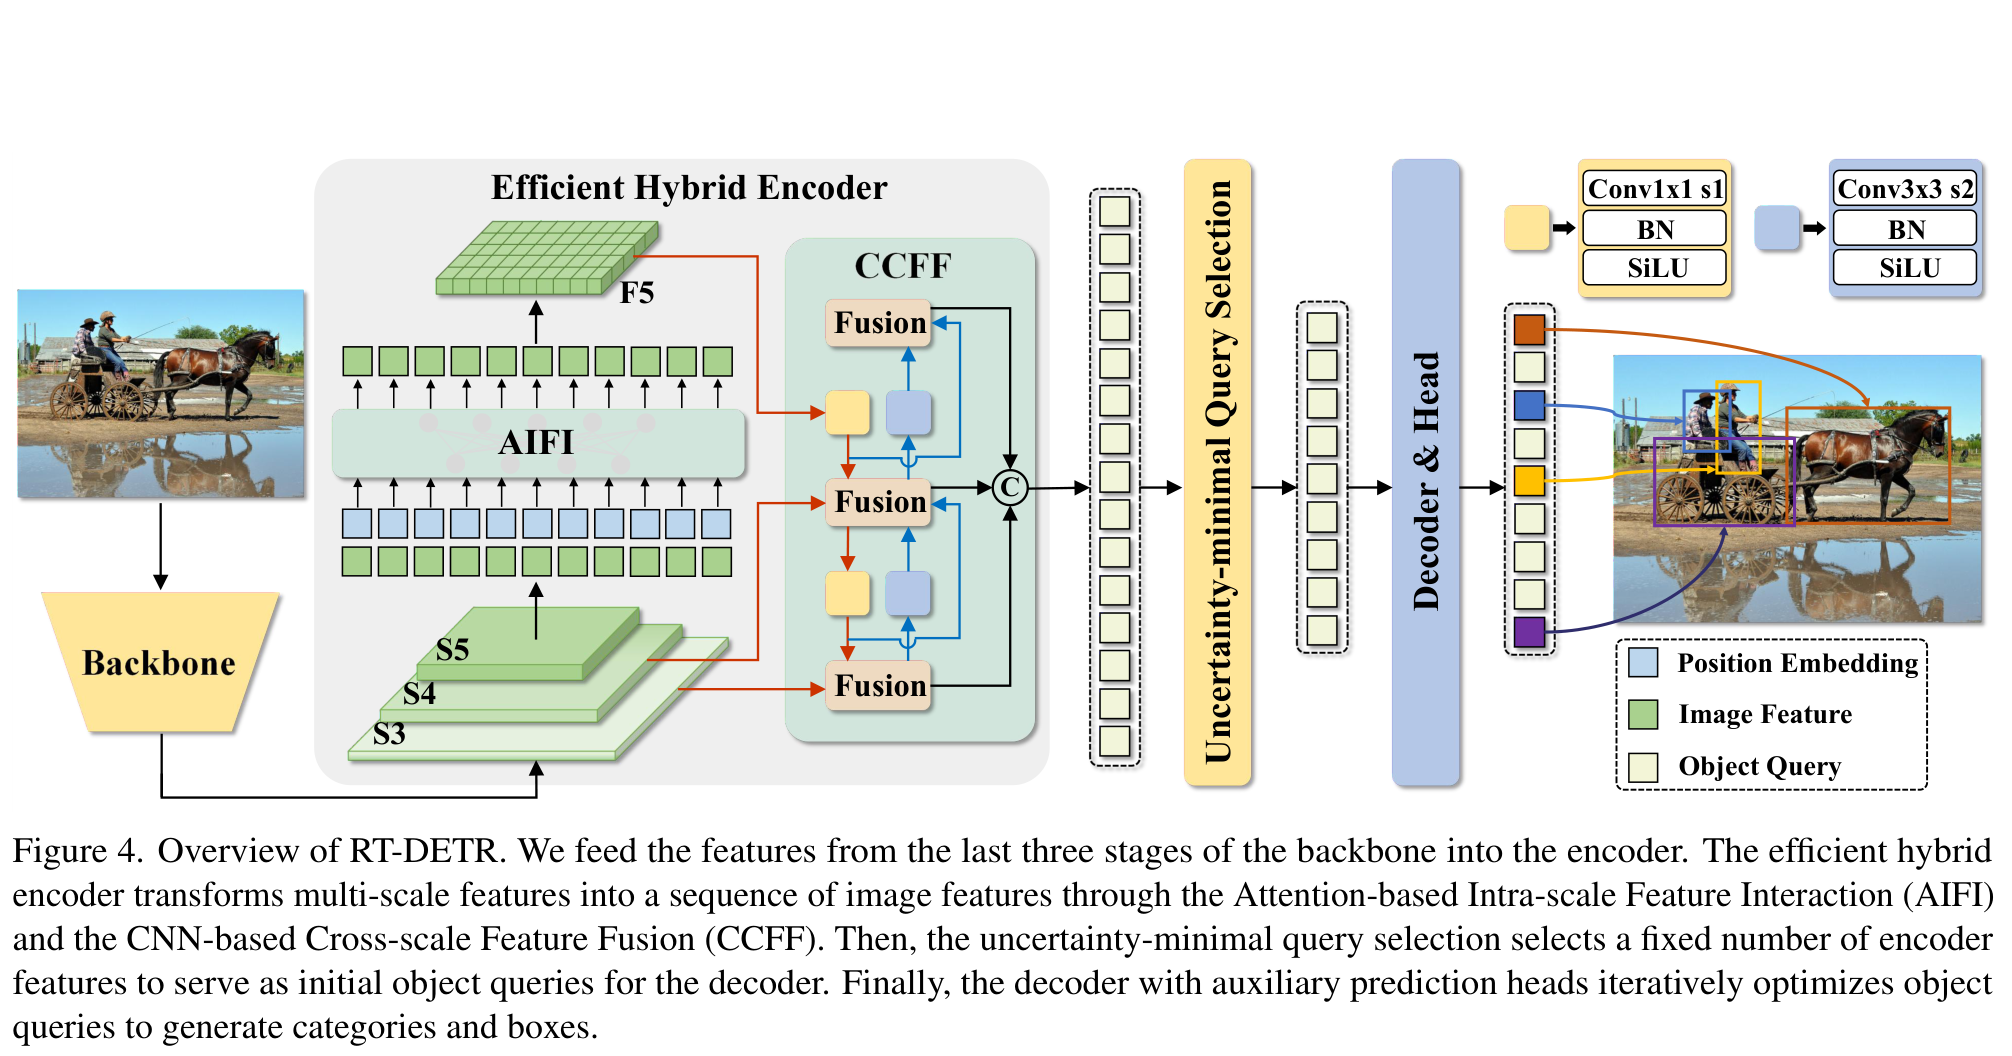
RT-DETR 还可通过调整 decoder 层数改变速度与精度。论文中 RT-DETR-R50 报告 53.1 AP 和 T4 上约 108 FPS,但速度依赖输入尺寸、TensorRT、精度和计时范围。与 DINO 或 YOLO 的比较必须使用同一测量条件,不能据此承诺任意部署都超过 100 FPS。
八、Group DETR 与 Co-DETR:训练时给更多监督
Group DETR 训练时使用多组 query,每组独立做一对一匹配,同一个真实物体因此获得多组监督;推理可只保留一组,保持一对一输出。
Co-DETR 引入一对多标签分配的辅助头,并利用额外监督改善 encoder 和 query 学习。辅助头可在推理时移除,但训练结构与计算成本并非完全不变。论文的 66.0 AP 等高端结果还涉及大型骨干与相应训练设置,不能和常规 R50 的 COCO 验证结果直接比较。
| 方法 | 主要问题 | 关键改进 |
|---|---|---|
| DETR | 检测流程依赖多种手工组件 | 集合预测与一对一匹配 |
| Deformable DETR | 密集注意力、收敛与小目标 | 稀疏采样、多尺度 |
| DAB-DETR | query 缺乏明确几何含义 | 动态锚框位置 query |
| DN-DETR | 早期匹配与监督不稳定 | 去噪重建与训练掩码 |
| DINO | 初始化、重复预测与框优化 | 混合选择、对比去噪、跨层梯度 |
| RT-DETR | 实时推理成本 | 高效混合 encoder 与 query 选择 |
这些研究互相借鉴,但并不是严格单线接力:稀疏注意力、query 表达和训练监督可以组合使用。
九、数据集与训练配置
COCO 2017 有约 118k 训练图像、5k 验证图像和 80 个目标类别。COCO AP 通常在 IoU 0.50~0.95 的多个阈值上平均,不能与 AP50 混淆。LVIS v1 有 1203 类和约 10 万训练图像,适合分析稀有、常见和高频类别。
AdamW、骨干使用较低学习率、水平翻转、随机裁剪和尺度变化是常见设置。主学习率常见于 量级,但不同版本的批大小、调度和权重衰减并不一致,应从官方配置开始。
迁移到自己的数据时,除了路径与类别数,还要检查类别 ID 映射、框坐标格式、空标注、图像尺寸和评估器。拥挤场景尤其需要关注 query 数量是否足够,以及小目标在缩放后的像素大小。
十、部署:没有 NMS 仍然需要验证
常见路径是 PyTorch → ONNX → TensorRT,但导出时可能遇到多尺度可变形注意力算子、动态 shape、插件和 decoder 实现问题。模型预处理与输出解码必须保持一致。
在环境与算子已经适配后,示意编译命令可以是:
trtexec --onnx=model.onnx --saveEngine=model.engine --fp16命令不是通用部署保证。动态输入需要按实际输入名设置 profile;FP16 需要目标硬件支持。构建成功后,应比较框与分数、验证数据集 AP,再测预处理、数据搬运、推理和结果筛选的总耗时。
MMDetection 提供多种 DETR 配置,Hugging Face Transformers 支持 DETR、Deformable DETR 等模型;实时应用可以先看官方 RT-DETR。RF-DETR 是另一条可关注的工程路线,安装和 ONNX 导出能力应以对应版本文档为准。
十一、如何选择
学习集合预测先看 DETR;理解稀疏注意力和多尺度看 Deformable DETR;研究 query 空间表达看 DAB-DETR;研究训练稳定性看 DN-DETR;建立高精度基线考虑 DINO;实时任务从 RT-DETR 的实际硬件表现评估起步。
先确定数据分布、延迟预算和硬件,再比较同条件下的精度、吞吐、单张延迟与显存。DETR 系列的价值,在于把集合预测逐步变成更稳定、更高效的检测系统。