GAN、DDPM、Latent Diffusion、Stable Diffusion 和 DiT 经常出现在同一条技术时间线上,但它们并不属于同一层概念:GAN 和扩散描述生成与学习方式,Latent Diffusion 描述计算发生在哪里,DiT 描述网络骨干,Stable Diffusion 则是一系列具体系统。
理解这些名字,可以始终问四个问题:图像怎样表示?模型学习什么?使用什么网络?推理如何得到图像?
一、先建立地图:目标、空间与骨干
| 名称 | 主要解决的问题 | 典型生成过程 |
|---|---|---|
| VAE | 学习可采样的潜变量与解码器 | 潜变量 → 解码器 → 图像 |
| GAN | 通过对抗学习生成逼真的样本 | 随机向量 → 生成器 → 图像 |
| DDPM | 学习逐步去噪的反向过程 | 噪声 → 多步去噪 → 图像 |
| Score-based 模型 | 学习噪声分布的对数密度梯度 | 用随机或确定性动力学逐步生成 |
| LDM | 降低高分辨率生成的计算成本 | 潜空间生成 → 图像解码 |
| Stable Diffusion | 将潜空间条件生成组织成可用系统 | 文本编码 → 潜空间生成 → 解码 |
| DiT | 用 Transformer 扩展生成骨干 | 对图像或潜变量 token 预测去噪量 |
| Flow Matching / Rectified Flow | 学习连接噪声与数据的向量场 | 沿学习到的速度场积分 |
DDIM、DPM-Solver 等主要涉及采样;CFG 是条件引导;LoRA、ControlNet 则分别涉及参数适配与额外控制。它们可以与基础生成架构组合使用。
二、VAE:先学会压缩与重建
VAE(Variational Autoencoder,2013)用 encoder 将图像映射到潜变量分布,再用 decoder 重建图像。训练目标兼顾重建和潜分布正则,常写成负 ELBO:
潜空间如果组织得足够好,就可以从先验采样 ,交给 decoder 生成图像。早期 VAE 在常见设置下容易产生平滑结果,但不能把“模糊”视为所有 VAE 的必然特性。
现代潜空间生成模型中的自动编码器也不一定就是原始 VAE:LDM 使用过 KL 正则或向量量化的表示,重建训练还可以加入感知损失和对抗损失。它们的职责主要是压缩和解码,不必独立完成整个复杂数据分布的建模。
三、GAN:生成器与判别器的对抗
Goodfellow 等人在 2014 年提出 GAN。生成器 从噪声生成样本,判别器 判断样本来自真实数据还是生成器。经典目标是:
实际训练常使用非饱和生成器损失等变体。生成器与判别器交替更新;部署生成时通常只需要生成器,一次前向就能得到图像,这是其速度优势。
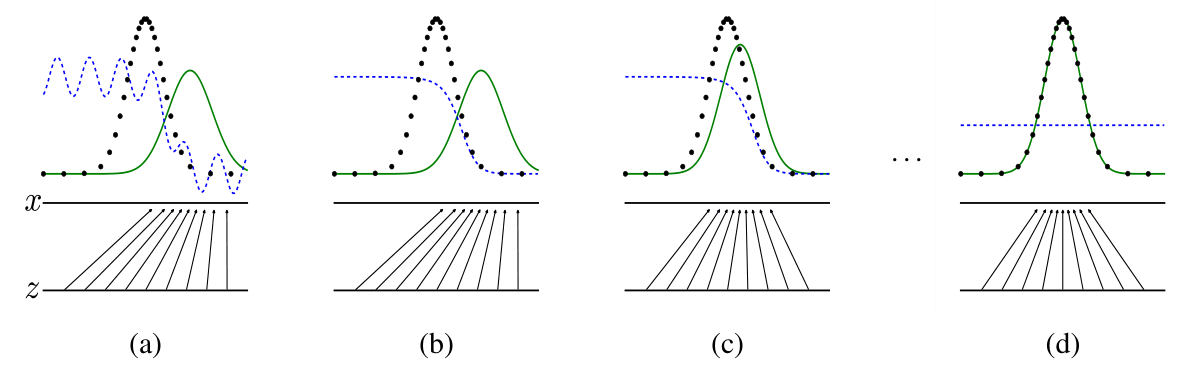
GAN 的难点包括训练平衡、模式坍塌与覆盖多样性。DCGAN 推广卷积架构,WGAN 用不同的分布距离与训练约束改善优化,StyleGAN 引入映射网络和分层风格控制;StyleGAN2 改善伪影,StyleGAN3 进一步关注抗混叠和等变性。
这些方法展示了高质量人脸等生成能力,但训练稳定性和开放域文本控制仍是挑战。扩散流行以后,GAN 仍可用于低延迟生成、重建与蒸馏,并没有彻底消失。
四、DDPM:把生成变成去噪学习
扩散生成已有更早工作,Ho 等人的 DDPM(2020)让这一范式广泛传播。前向过程逐渐给真实图像加高斯噪声,反向过程由网络学习恢复结构。
训练可以直接采样任意时刻:
典型简化目标要求网络预测噪声:
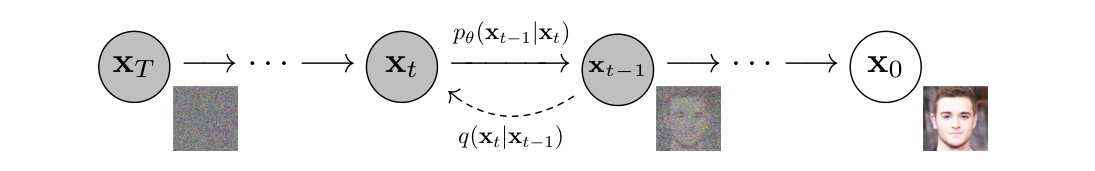
典型骨干是带时间嵌入的 U-Net:下采样提取上下文,上采样恢复空间细节,跳跃连接保留局部信息,并可加入注意力。训练一次随机采样一个 ,不需要为每张图完整执行全部去噪步骤;生成时才需要迭代。
DDPM 的效果来自大量数据上的分布学习,不是把某张训练图的噪声倒放。它也不是必须预测 :模型还可以预测干净样本或 等参数化,采样器必须与训练约定匹配。
五、Score-based、DDIM 与采样器
Score-based 方法学习带噪数据的 。Song 等人的 SDE 框架把不同噪声过程联系起来:反向 SDE 可以随机采样,对应的 probability flow ODE 可以确定性积分。理想条件下二者具有一致的边缘分布,但离散计算会带来误差。
DDIM 提供与 DDPM 相关的非马尔可夫采样构造,可使用更少步骤,并在特定设置下让给定初始噪声产生确定性结果。它主要改变采样过程,通常不要求从零重新训练一个不同的图像理解网络。
DPM-Solver 等进一步利用数值求解结构提高采样效率。步数减少通常有质量取舍;“训练有 1000 个噪声时刻”不等于“推理必须跑 1000 次网络”。
六、LDM:把扩散搬到潜空间
像素空间高分辨率扩散昂贵。Rombach 等人的 Latent Diffusion Models(CVPR 2022)先学习自动编码器,再在压缩潜变量上训练扩散网络。
训练图像 x → encoder → 潜变量 z
                            ↓ 加噪
                  条件去噪网络学习恢复

生成:潜空间噪声 → 迭代生成 z → decoder → 图像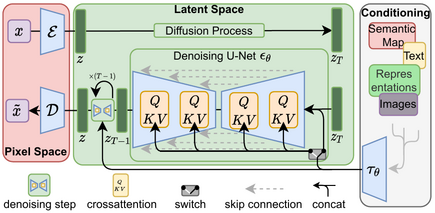
例如 SD 1.x 常用的压缩倍率让 图像成为 潜张量。空间位置减少 64 倍,考虑通道后元素数减少 48 倍;这不意味着端到端计算或显存固定下降相同倍数。
压缩也有代价:decoder 重建能力限制细节与文字质量。自动编码器通常先训练,扩散阶段固定它;新的方法也可能联合优化或替换表示。
七、Stable Diffusion:具体系统,而非单一公式
早期 Stable Diffusion 将自动编码器、文本编码器、条件 U-Net 与采样器组合起来。文本经编码产生条件向量,U-Net 通过交叉注意力利用条件,在潜空间迭代,最后 decoder 解码。
| 系列 | 典型架构重点 | 不能混用的地方 |
|---|---|---|
| SD 1.x | CLIP 文本条件、潜空间 U-Net | checkpoint、文本编码与潜空间约定 |
| SD 2.x | OpenCLIP 与不同训练/预测配置 | 不能假定与 1.x 完全相同 |
| SDXL | 更大 U-Net、双文本编码器、尺寸等附加条件 | refiner 是可选阶段,不是每次必需 |
| SD3 / SD3.5 | MMDiT、多种文本编码、Rectified Flow 路线 | 不再是旧版 U-Net DDPM 架构 |
版本之间不仅是参数变多。必须同时确认文本编码器、自动编码器、噪声调度、预测目标和条件接口。
Classifier-free guidance(CFG)利用有条件与无条件预测增强条件影响,概念式为:
不同库对 guidance scale 的定义和应用方式可能不同。更大 guidance 不一定更好,可能降低多样性或产生过饱和与伪影;一些蒸馏模型又有独立约定。
八、DiT:用 Transformer 替换生成骨干
Peebles 与 Xie 的 DiT(ICCV 2023)把潜变量切成 patch tokens,用 Transformer blocks 预测扩散所需的输出,并将时间与类别条件通过 adaLN 等机制注入网络。
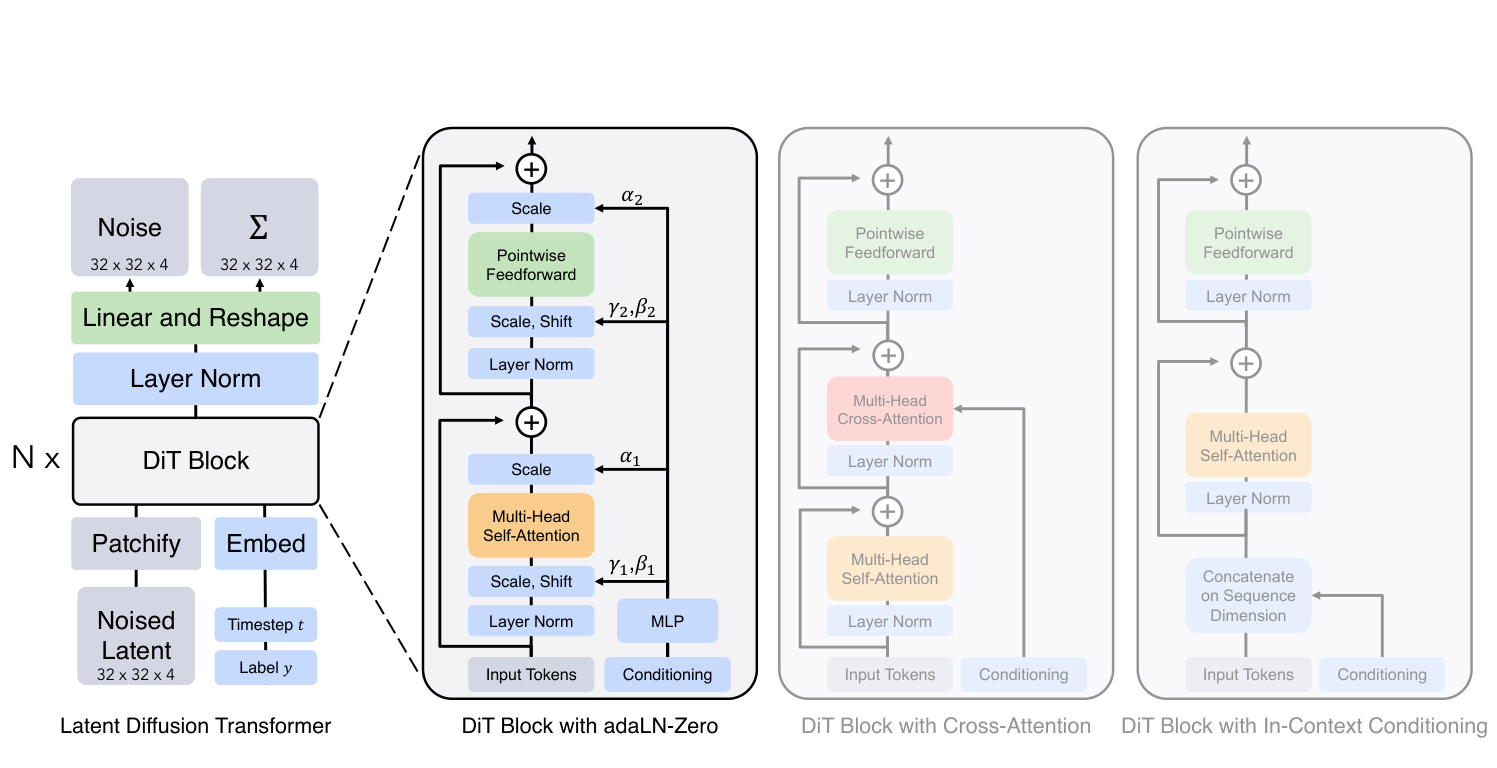
原始 DiT 主要验证类别条件 ImageNet 生成,不是完整的开放域文本生图系统。它说明扩散骨干可受益于规模扩展,但 full attention 对 token 数的平方成本仍在;更小 patch 或更高分辨率会增加计算。
PixArt 系列进一步研究文本条件 Transformer 生成。SD3 的 MMDiT 则为文本和图像设置不同参数路径,通过联合注意力交换信息。FLUX 的公开架构也是潜空间 Transformer 与流生成路线的代表。它们都不能简单等同为原始 DiT 的原样放大。
九、Flow Matching 与 Rectified Flow
直觉:让概率密度从噪声流到数据
生成问题里,一张 的彩色图片可以唯一对应一个 的三万维向量。在这个空间里随机采样,几乎总是得到噪声而不是真实图片,因为真实图片的分布极度不均匀,只占据其中很小的一部分。生成任务因此可以概括为:找到这个 ,然后从中采样;每采样一次,就得到一张新图片。
Flow Matching 把这件事理解为概率密度在流动:从已知的简单分布 (本教程里取标准正态分布)出发,一步步搬运到 。下面用低维图像建立直观,实际处理的维度通常是几万到几十万。
三个基础概念:轨迹、向量场、流
轨迹(trajectory) 记录一个点在不同时刻的位置, 表示时刻 的位置。Flow Matching 中时间取 : 在起点, 在终点,中间连续且每个时刻只有一个确定位置。
向量场(vector field) 给出位置 在时刻 的速度。速度就是位置随时间的变化率,于是
这是一个常微分方程(ODE)。给定初始位置 和向量场 ,轨迹就被唯一确定:从 按当前速度走一小步,到新位置后重新查询速度,如此重复到 。向量场描述的是运动规则,而不是某一条具体轨迹。
流(flow) 是一族轨迹的集合,每条轨迹都服从同一个向量场:
第二条式子把流和向量场直接绑在一起。在我们讨论的范围内二者一一对应:知道流可以求出向量场,知道向量场也可以求出流。
一个可以验证的例子
取向量场 ( 为常数矩阵),对应的流是 。代入上面的公式验证:
- 初始条件: 时 ,起点落在 。
- 时间导数:,满足 ODE。
所以 与 是一组配对的向量场与流。
学习目标:直接回归速度
Flow Matching 用神经网络参数化向量场 ,训练目标是让它诱导的流起点落在 、终点落在 。训练时不必真的模拟整条轨迹,而是直接回归某个概率路径上的速度。以噪声到数据的线性路径为例:
因为 和 都是现成的,训练可以像扩散模型一样,一次随机采样一个 就完成一次更新,不需要展开整个求解过程。回归目标由两个端点直接给出,不必为每个 维护 之类的缩放系数,需要调的超参数更少,这也是它在实践中被认为训练更稳的原因之一。
这里使用噪声到数据的时间约定,有些实现方向相反;路径形式和端点耦合也可以改变。
生成:沿学到的向量场积分
训练完成后,从 采样 ,用数值积分把点推到 :
@torch.no_grad()
def sample(v_theta, x, cond, steps=50):
    """x 从 p_init 采样,例如 torch.randn(1, 3, 1024, 1024)。"""
    h = 1 / steps                              # 时间间隔
    for i in range(steps):
        t = i * h
        x = x + h * v_theta(x, t, cond)        # 沿速度场走一步
    return x                                   # 即 x_1
这是最简单的 Euler 求解器,steps 对应前面的 ,每步只需一次网络前向。 越大越接近真实轨迹,代价也越高;换成高阶求解器可以在相同步数下减小离散误差。
Rectified Flow:让轨迹更直
Rectified Flow 关注把连接端点的流学得更直接,并可通过 reflow 等过程改善轨迹。它与 Flow Matching 联系紧密,但名称、理论构造和具体训练流程不能完全互换。SD3 使用该路线,不意味着所有 DiT 都使用 flow,也不意味着 flow 必须搭 Transformer。
“轨迹更直”有助于少步求解,但复杂分布仍需要学习,几步高质量生成通常还需要合适训练、求解器或蒸馏。相比传统扩散,流匹配直接回归速度场、对路径的约束更强,实践中常能在更少步数内得到可用结果;但具体收益取决于路径设计、求解器与蒸馏方案,不能只看方法名字。
十、Flow Matching 现在被用在哪些地方
流匹配已经不只是论文里的备选方案,而是许多已发布系统的默认生成方式。
| 领域 | 代表系统 | 流匹配承担的角色 |
|---|---|---|
| 文本生图 | SD3 / SD3.5、FLUX.1 | Rectified Flow 配合 MMDiT,替换旧版 DDPM 调度与 U-Net |
| 视频生成 | Wan 2.1/2.2、HunyuanVideo、Mochi 1 | 3D 因果 VAE 压缩时空潜变量,流匹配 DiT 负责生成 |
| 语音与音频 | Matcha-TTS、VoiceBox、F5-TTS、CosyVoice 2 | 生成声学特征或音频潜变量,换取更低的步数与延迟 |
| 3D 生成 | TRELLIS、Hunyuan3D 2.0 | 在稀疏结构与结构化潜变量上做 rectified flow |
| 机器人动作 | π0 等 VLA 的 action expert | 把连续动作块当作生成目标,替代单点回归 |
| 科学计算 | 分子与蛋白质设计、气象与时空插补 | 作为通用的“分布到分布”传输工具 |
视频生成是当前最集中的战场。 开源视频模型普遍采用“3D 因果 VAE + 潜空间 DiT + flow matching”的组合:先把视频压缩到时空潜变量,再让流匹配骨干生成。潜变量压低了单帧的计算成本,流匹配则让时序上相邻的预测更连贯、采样步数更少。相比在像素空间逐帧做扩散,这套组合在时序一致性和推理成本上都更划算,因此成为近两年开源视频模型的主流配方。
语音和音频对步数最敏感。 实时 TTS、语音克隆和音效生成都希望在少数几步内出结果。流匹配的少步特性与这些需求吻合,所以从 Matcha-TTS 到后来的 F5-TTS、CosyVoice 2,都把 conditional flow matching 当作声学建模的主要方案。
机器人是较新的落地方向。 π0 一类 VLA 模型把动作生成交给用 conditional flow matching 训练的 action expert:模型一次输出一段连续动作,而不是离散动作 token 或单一回归值。之所以用生成式目标,是因为同一个任务往往有多种合理做法——人类演示下的动作分布常常是多峰的,用 L2 回归容易落到这些模式之间的“平均动作”上,而生成式建模可以保留多个可行解。
3D 生成把它用在潜变量上。 TRELLIS 先在稀疏结构上做一次 rectified flow,再在结构化潜变量上生成特征;Hunyuan3D 2.0 则先做几何、再单独做纹理。它们延续了 LDM 的思路:把昂贵的高维生成搬到压缩后的表示上。
它也在图像和视频之外出现。 只要问题可以描述成“把一个分布搬到另一个分布”,流匹配就能用:分子与蛋白质构象生成、气象场与时空数据插补等都在使用。在这些场景里,它更像一种通用建模工具,而不是图像生成的附属技术。
需要注意的是,采用同一种训练范式不等于系统可以互换。时间方向、路径形式、噪声调度、求解器与蒸馏方式各有约定,把不同仓库的组件拼在一起通常要先对齐这些接口。反过来,flow matching 也不必然与 Transformer、潜空间或文本条件绑定——它可以只是“用什么目标学习”这一层的一个选择。
十一、还有哪些方法值得放进地图
自回归模型逐步预测像素或离散视觉 token,代表包括 PixelCNN 和基于 VQ-VAE/VQGAN token 的 Transformer。MaskGIT 则通过迭代预测被遮盖的 token 并行生成,不能直接归为普通逐 token 自回归。
Consistency Models、LCM、对抗蒸馏等路线追求少步推理,有些从扩散教师蒸馏,有些支持独立训练。少步模型可能改变 guidance、步数与分辨率约定,不能只给原始采样器把步数调小来获得同样效果。
LoRA 用少量参数适配骨干,DreamBooth 面向个性化,ControlNet 引入边缘、姿态、深度等条件,IP-Adapter 利用图像条件。这些通常是控制与适配方法,不是新的完整概率生成范式。
十二、训练和生成时,谁在工作
| 系统 | 训练对象的典型配置 | 生成时需要 |
|---|---|---|
| GAN | 生成器与判别器 | 生成器 |
| 像素 DDPM | 去噪网络 | 去噪网络与采样器 |
| 文本 LDM | 已训练自动编码器,训练条件去噪网络;文本编码器常冻结 | 文本编码器、去噪网络、decoder |
| 图生图/修复 | 条件生成骨干,依方案增加输入与掩码 | 还需要 encoder 处理输入图像 |
| Flow + Transformer | 条件速度场网络 | 网络与 ODE 求解过程、必要的解码器 |
具体配方可能微调文本编码器或自动编码器,不能把“冻结”当作绝对要求。文生图从随机潜变量起步时不需要编码一张输入照片,但图生图需要。
十三、横向对比:把所有方法放进一张表
| 方法 | 学什么 | 生成方式 | 代表系统 | 主要代价 |
|---|---|---|---|---|
| VAE | 重建图像,并约束潜变量分布 | 潜变量一次解码 | 早期 VAE;LDM 中的自动编码器 | 重建偏平滑,潜空间容量有限 |
| GAN | 生成器与判别器的对抗目标 | 生成器一次前向 | DCGAN、StyleGAN 系列 | 训练不易平衡,易模式坍塌 |
| DDPM | 预测噪声 (也可以是 或 ) | 像素空间多步迭代去噪 | DDPM 及后续像素空间扩散 | 迭代次数多,高分辨率昂贵 |
| Score-based / SDE | 带噪数据的 | 反向 SDE 随机采样,或 probability flow ODE 确定性积分 | Song 等人的 SDE 框架 | 离散化误差明显,依赖求解器设置 |
| DDIM / DPM-Solver | 不改变已训练的网络,只重新设计采样 | 少步确定性或半确定性迭代 | DDIM、DPM-Solver | 压缩步数伴随质量取舍 |
| LDM | 在压缩潜空间里学条件去噪 | 潜空间迭代后由 decoder 解码 | SD 1.x / 2.x、SDXL | 细节与文字受自动编码器重建能力限制 |
| DiT | 扩散目标不变,骨干换成 Transformer | 对潜变量 patch 序列迭代去噪 | DiT、PixArt、MMDiT | 注意力随 token 数呈平方成本 |
| Flow Matching / Rectified Flow | 概率路径上的速度场 | 沿速度场积分 ODE,常可少步 | SD3 / 3.5、FLUX、Wan、HunyuanVideo、π0 | 复杂分布仍需充分训练,少步多依赖求解器或蒸馏 |
| 自回归 / 掩码生成 | 下一个视觉 token,或被遮盖的 token | 逐 token 解码,或迭代并行填补 | PixelCNN、VQGAN + Transformer、MaskGIT | 序列长,误差逐步累积 |
| 一致性模型 / 蒸馏 | 从教师蒸馏,或自洽约束 | 一到数步直接出结果 | Consistency Models、LCM | 采样约定不同,不能只把步数调小 |
读这张表时可以回到开头的四个问题:图像怎样表示、模型学什么、用什么网络、推理如何得到图像。 “学什么”是目标层,“生成方式”同时暴露了生成发生在哪个空间、大致需要多少步,“代表系统”则提醒同一个名字底下往往是一组配方而不是单一公式。
也正因为空间、目标和骨干可以自由组合,才会出现“潜空间 + Transformer + 流匹配”这样的新系统,而不是某个方法整体取代另一个。
十四、如何选择和实际入门
建立现代文本生成基线可从成熟潜空间模型开始;研究规模扩展和文本交互关注 DiT、MMDiT;低延迟应用同时评估少步蒸馏与实际硬件,特定封闭域可考虑 GAN。不要仅凭方法年代判断适合程度。
用 Diffusers 加载模型时,以对应 model card 和库版本为准。先固定提示词、种子、分辨率、步数和 guidance,理解 pipeline 中 text encoder、autoencoder、生成骨干与 scheduler 的作用,再尝试 LoRA 或额外控制。
评估除了样本好看,还应看提示遵循、对象关系、文字、细节、多样性、失败样例和延迟。FID 依赖数据与特征提取设置,不能独自代表文本对齐;不同基准上的指标也不宜直接排名。
这条路线最终可以理解为三个可以组合的选择:在什么空间生成,用什么目标学习,用什么骨干预测。 GAN 与扩散体现不同学习方式;LDM降低空间成本;Transformer 扩展关系建模;流匹配与蒸馏进一步探索生成路径和推理效率。
参考资料
- VAE:Auto-Encoding Variational Bayes
- GAN
- StyleGAN
- DDPM
- Score-based SDE
- DDIM
- LDM
- Classifier-Free Guidance
- SDXL
- DiT
- SD3:Scaling Rectified Flow Transformers
- Flow Matching
- Rectified Flow
- Consistency Models
- MaskGIT
- π0:Vision-Language-Action Flow Model
- Matcha-TTS
- F5-TTS
- CosyVoice
- TRELLIS 官方仓库
- Hunyuan3D 2.0 官方仓库
- HunyuanVideo 官方仓库
- Wan 2.1 官方仓库
- Mochi 1 官方仓库
- FLUX 官方仓库
- Diffusers