说起 DINO,有人指自监督视觉预训练,有人指端到端检测器,还有人实际使用的是文本条件检测模型 Grounding DINO。名字相近,训练目标与输出却不同。理解它们,先问:输入是什么、监督来自哪里、最终输出什么?
一、四个名字先分开
| 名称 | 代表工作 | 主要信号 | 直接输出 |
|---|---|---|---|
| 自监督 DINO | Caron 等,2021 | 图像多视图教师学生一致性 | 全局与局部视觉特征 |
| DINOv2 | Oquab 等,2023 | 图像级、patch 级自监督与大规模训练 | 通用视觉特征 |
| 检测 DINO | Zhang 等,ICLR 2023 | 框、类别、集合匹配与去噪 | 类别和边界框 |
| Grounding DINO | Liu 等,2023 公开,ECCV 2024 | 文本与区域对齐及检测监督 | 文本条件下的框和相关分数 |
自监督 DINO 得名于 self-distillation with no labels。检测 DINO 的名称来自 DETR with Improved deNoising anchOr boxes。它们不是同一个算法的两个版本。
二、自监督 DINO:教师怎样从学生中产生
同一张图经过裁剪、颜色扰动、模糊等增强,形成多个视图。学生处理全局与局部视图,教师通常处理全局视图,学生学习预测教师产生的目标分布。
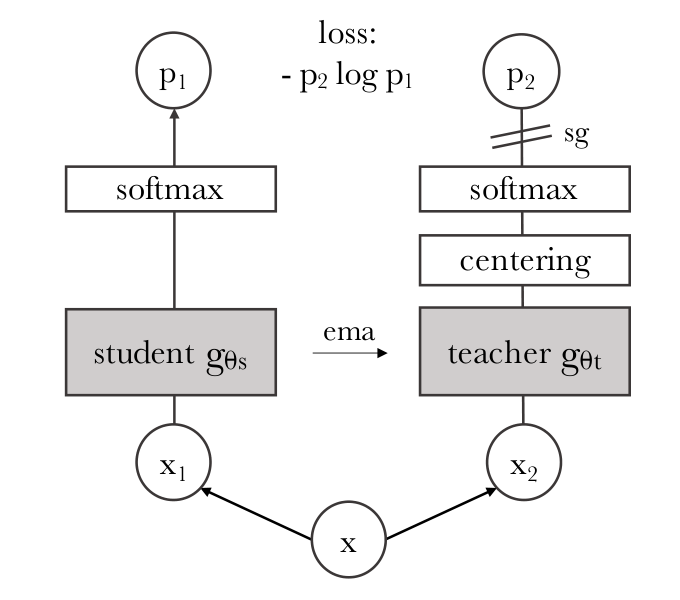
教师不通过这项损失直接反向更新,而使用学生参数的指数移动平均:
这一阶段教师与学生通常架构相同,教师目标停止梯度。原始 DINO 对教师输出做居中,并以较低温度锐化其分布。居中抑制某些维度长期占主导,锐化避免目标过于均匀,它们配合跨视图训练缓解表征坍塌。
原文的“学生居中、教师锐化”需要修正。DINOv2 又使用 Sinkhorn-Knopp 等目标归一化方案,不能把后续配方完全等同于原始 DINO。
三、DINOv2 加入局部监督与规模化训练
DINOv2 不只是把 DINO 网络放大。它结合图像级 DINO 损失、patch 级 iBOT 损失、KoLeo 正则,以及大规模数据整理和模型蒸馏。
- 图像级损失促进不同视图的全局表示一致。
- iBOT 让学生在部分 patch 被遮盖的输入上预测完整教师视图中相应位置的目标分布。它不是直接重建 RGB 像素。
- KoLeo 利用批次内特征的近邻距离鼓励表示分散,减少嵌入拥挤。
- 图像级与 patch 级投影头使用不同参数,骨干仍然共享,所以不能说两个任务完全互不影响。
总目标可概括为:
权重、掩码和温度等配置应按对应论文或代码版本理解。
四、没有文本,为什么可以当骨干
骨干负责把图像转成下游可用的表示,文本对齐不是必要条件。监督分类、视觉自监督和图文对齐都能训练视觉骨干。
DINOv2 有全局特征和具有空间组织的 patch 特征:前者可用于分类、检索,后者可恢复为空间网格,接分割、深度或检测结构。
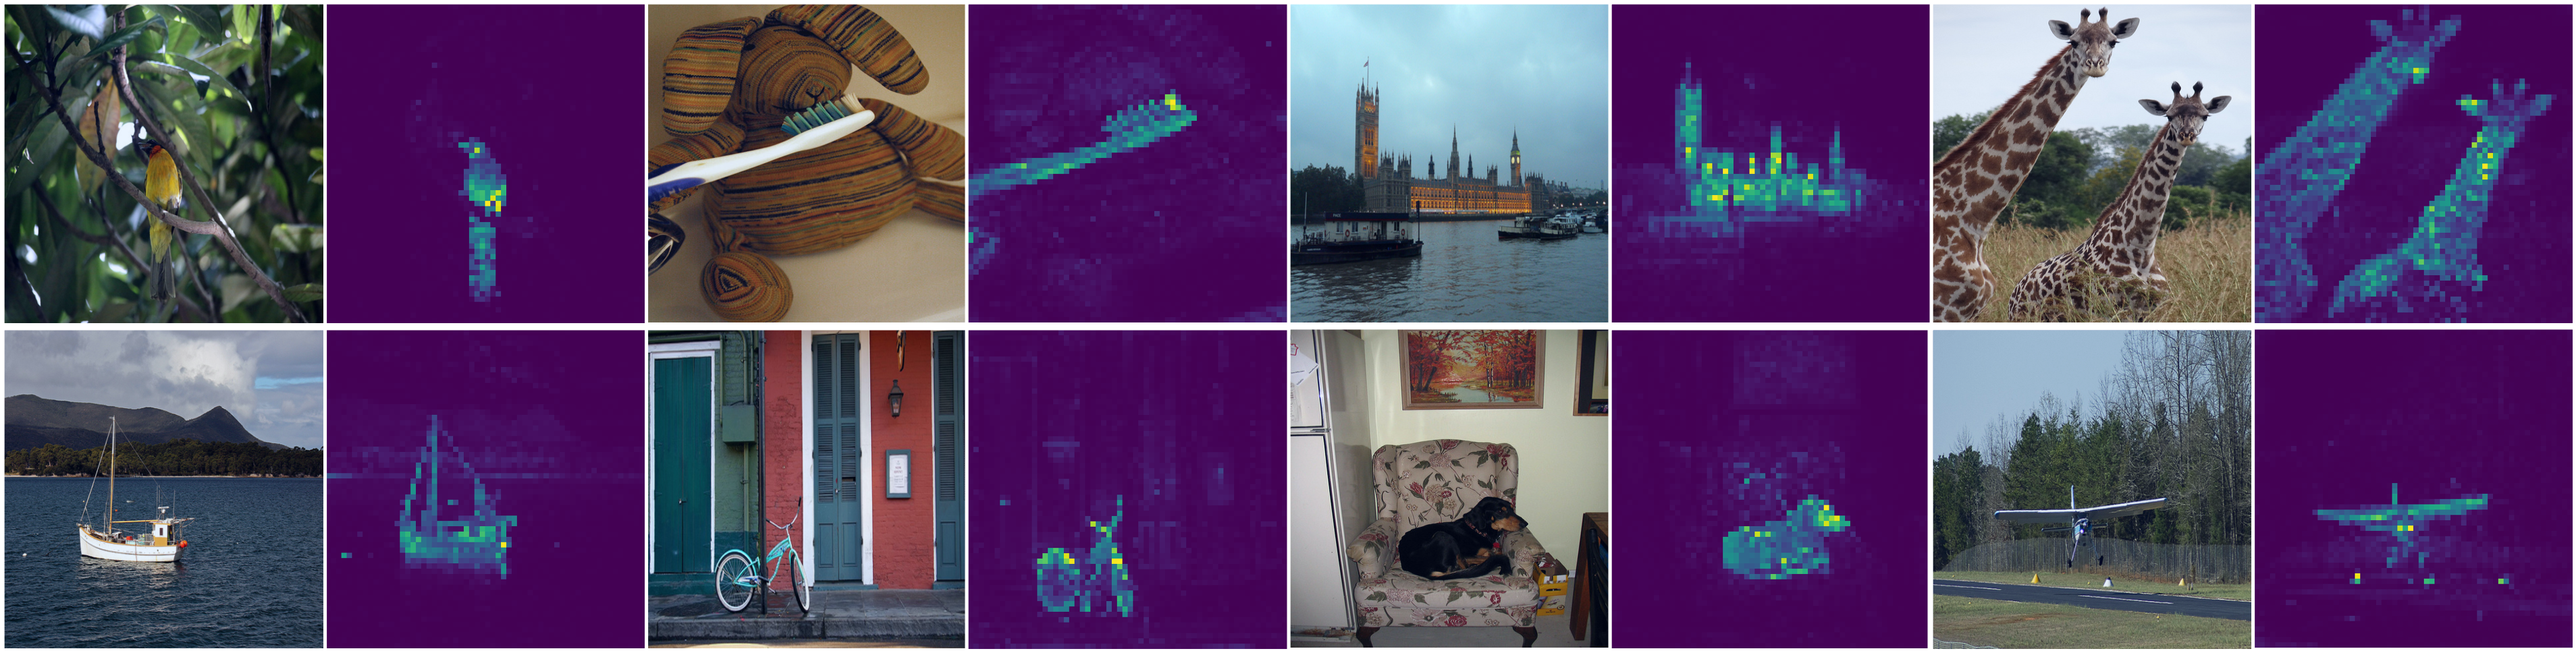
这类训练可能提升部分遮挡与外观变化下的稳健性,但不保证任意遮挡都不影响识别。不能断言同一物体所有部件被映射到同一点,也不能说 CNN 只能看狗头而 ViT 能自动补全语义。CNN 同样能学习上下文,训练目标和数据非常关键。
冻结骨干接轻量头是常见迁移方案;复杂任务可能需要多尺度适配、专用 decoder 或全量微调。DINOv2 本身不会直接给出检测框。
五、DINOv2 与 ViT、数据规模的关系
ViT 是架构,DINOv2 是训练配方与模型系列。官方 DINOv2 使用 ViT,例如 dinov2_vitb14 的 b 表示 Base,14 表示 patch 大小。
| 模型 | 近似参数量 |
|---|---|
| ViT-S | 21M |
| ViT-B | 86M |
| ViT-L | 300M |
| ViT-g | 1.1B |
LVD-142M 包含约 1.42 亿张图像,由约 12 亿候选图像整理、检索和去重而来,并不是公开可直接下载的同规模训练集。预训练损失不直接使用人工类别标签,但数据整理利用了参考数据集等信息,因此“全流程没有任何人工标注信息”过于绝对。
官方小模型还涉及从大型教师蒸馏,不能认为每个模型都独立重复相同自监督训练。也不能仅替换骨干就声称完整复现了官方 DINOv2,数据和训练配方同样重要。
六、DINOv2 与 CLIP 如何选择
CLIP 使用配对图文进行对比学习,建立图像与文本可比较的嵌入空间。DINOv2 主要学习视觉表示,没有原生文本对齐接口。
| 需求 | DINOv2 | CLIP |
|---|---|---|
| 文本零样本分类 | 需要额外对齐 | 可用文本构造类别原型 |
| 图文检索 | 需要额外模块 | 原生优势 |
| 密集空间预测 | patch 表征值得优先评估 | 可以使用,通常需要适配 |
| 检测框或掩码 | 需要任务头 | 同样需要额外结构 |
CLIP 可帮助开放词汇任务,但它自身不是完整检测器。DINOv2 也不保证在所有密集任务上胜过 CLIP。两者可以组合,最终应看具体数据和评估协议。
七、检测 DINO:监督框与类别
检测 DINO 使用多尺度特征、decoder queries 和一对一集合匹配,继承并改进 Deformable DETR、动态锚框和去噪训练等思路。
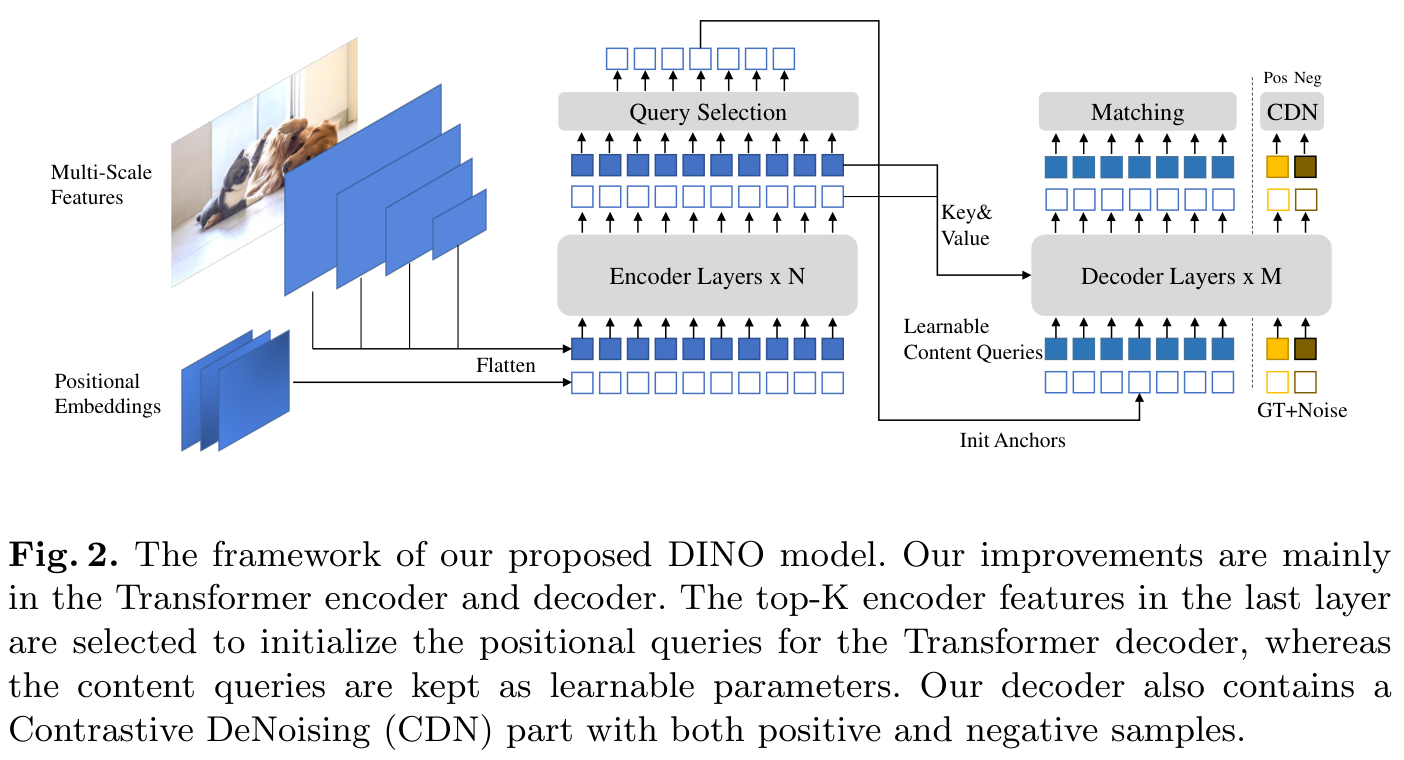
三个关键改进是:
- 对比去噪:小扰动正样本恢复真实目标,较大扰动负样本学习无物体;去噪查询仅在训练使用,掩码防止标签泄漏。
- 混合 query 选择:从 encoder 候选初始化位置部分,内容部分保持可学习参数。
- Look Forward Twice:改变跨层框细化的梯度路径,让后续监督帮助前层更新,而不是简单增加相邻框差异损失。
论文的 R50、12/24 epoch 配置报告 49.4/51.3 AP,需要结合特征尺度与训练设置比较。原文中 49.4 与 46.3 “相差 6 点”的算术不对,差值是 3.1,配置是否可比还要进一步核对。
推理不用传统 NMS,但仍需分数筛选与坐标转换。更多演进可参考本站的DETR 系列博客。
八、Grounding DINO:文本条件的检测
Grounding DINO 利用图像和文字,通过跨模态特征融合、语言引导 query 选择与 decoder 找到相关区域。它与检测 DINO 有技术联系,但不是简单把固定类别名称改成文本,也不是 DINOv2 的升级版。
尤其要注意框架命名:Transformers 的 GroundingDino 不能直接当成闭集检测 DINO 的接口。选库时检查模型类、检查点和所支持的训练方式,不要只搜索同名关键词。
九、实操:先跑特征,再接任务
官方 Torch Hub 加载示例:
import torch
model = torch.hub.load("facebookresearch/dinov2", "dinov2_vitb14")
model.eval()

# images 是正确缩放、归一化的 [B, 3, H, W] 张量。
# 空间尺寸需匹配 patch 网格;此处只展示特征接口。
with torch.inference_mode():
    features = model.forward_features(images)
    global_features = features["x_norm_clstoken"]
    patch_features = features["x_norm_patchtokens"]
首次加载需要下载代码与权重。带 registers 等检查点可能有额外 token 约定,应按文档使用。全局特征可用于线性探测或检索,patch 特征可接密集任务结构。
检测 DINO 可从官方实现或 MMDetection 起步,准备数据、类别映射、框格式和评估器。去噪查询通常由模型训练流程生成,不必一概重写数据加载器。
通用视觉表示先评估 DINOv2,闭集端到端检测看检测 DINO,文本指定开放类别看 Grounding DINO,图文检索看 CLIP。模型身份由训练信号和输出决定,不能只靠名字判断。
参考资料
- DINO 原论文 · 官方仓库
- DINOv2 原论文 · 官方仓库
- iBOT
- CLIP
- 检测 DINO · 官方仓库
- Grounding DINO · 官方仓库