在目标检测、实例分割和语义分割里,模型经常需要同时处理大物体和小物体。远处的车只有几个像素,近处的卡车却占据大半张图;同一张图里还可能同时出现细小裂纹和大块结构。
卷积网络逐层下采样时,深层特征的语义越来越强,但空间分辨率越来越低;浅层特征保留了边缘和位置,却不太知道“这是什么”。视觉特征融合要解决的,就是怎样把这些不同层级、不同感受野或不同位置之间的信息合起来。
FPN、PANet、BiFPN、ASPP 和 Non-local 经常被放在同一篇入门文章里,但它们并不解决完全相同的问题:前三者主要做跨层特征金字塔,ASPP 在同一层并行获取多尺度上下文,Non-local 则让远距离位置直接建立数据依赖。
| 方法 | 代表性论文 | 融合维度 | 关键机制 | 常见任务 |
|---|---|---|---|---|
| FPN | CVPR 2017 | 不同层级 | 自顶向下 + 横向连接 | 目标检测、实例分割 |
| PANet | CVPR 2018 | 不同层级与 RoI | 增加自底向上路径、跨层 RoI 聚合 | 实例分割、检测 |
| BiFPN | CVPR 2020 | 不同层级 | 双向路径 + 可学习归一化权重 | 高效目标检测 |
| ASPP | DeepLab 系列;DeepLabv3 2017 | 同一层不同感受野 | 并行空洞卷积与图像级池化 | 语义分割 |
| Non-local | CVPR 2018 | 任意位置之间 | 全局相似度加权聚合 | 视频理解、检测、分割 |
一、FPN:把深层语义传回高分辨率特征
FPN 的全称是 Feature Pyramid Network,即特征金字塔网络。Tsung-Yi Lin、Piotr Dollár、Ross Girshick、何恺明等人在 Feature Pyramid Networks for Object Detection 中提出该结构,论文发表于 CVPR 2017。
为什么需要 FPN
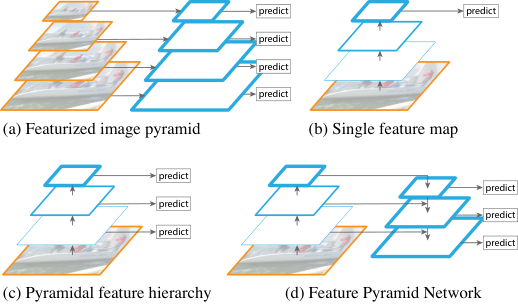
传统检测器可以在输入图像上建立图像金字塔,但同一张图要重复跑多次骨干网络,计算量很大;也可以只用卷积网络最顶层的特征,但高层特征分辨率低,小目标的定位细节容易消失。
FPN 观察到,普通卷积网络本身就已经产生了一个分辨率逐步降低、语义逐步增强的层级结构。与其重新处理多张缩放后的图像,不如把这些已有特征组织成一个“特征金字塔”。
具体怎么做
以 ResNet 为例,把各阶段输出记为 C2、C3、C4、C5。随着层数增加,空间分辨率通常每次减半,而通道和语义抽象程度增加。FPN 从最高层 C5 开始:
- 用 1×1 卷积把 C5 的通道数调整到统一宽度,得到顶部的 P5。
- 将 P5 上采样两倍,与经过 1×1 卷积的 C4 逐元素相加,得到 P4。
- 按相同方式继续处理 C3、C2,得到 P3、P2。
- 常见实现还会在每个融合结果后接 3×3 卷积,减轻上采样带来的混叠并生成检测头使用的特征。
核心公式可以写成:
P_l = Conv3×3(Conv1×1(C_l) + Upsample(P_{l+1}))这里的“加法”不是把图像像素直接相加,而是要求空间尺寸和通道数已经对齐。不同检测器使用的层数也可能不同:P2–P5 是常见示意,某些 RPN、RetinaNet 或其他检测头还会从 P5 继续生成 P6、P7。
深层特征提供“它可能是一个人或一辆车”的语义,浅层特征提供更精确的边界与位置。FPN 让检测头可以在不同尺度上使用同时具备这两类信息的特征图。
FPN 的边界
FPN 的主路径是自顶向下的,低层定位信息仍然要依靠横向连接进入融合结果。它解决了“不同尺度都需要语义”的问题,但没有显式地为低层特征再建立一条直接通往高层的路径;这正是 PANet 继续改进的地方。
FPN 也不是只服务 Faster R-CNN。它可以作为检测或实例分割骨干与头部之间的 feature neck,但具体的层分配、采样方式和预测头,仍由下游框架决定。
二、PANet:再加一条自底向上的捷径
PANet 的全称是 Path Aggregation Network,即路径聚合网络。Shu Liu、Lu Qi、Haifang Qin、Jianping Shi 和 Jiaya Jia 在 Path Aggregation Network for Instance Segmentation 中提出该方法,论文发表于 CVPR 2018。
从 FPN 到双向路径
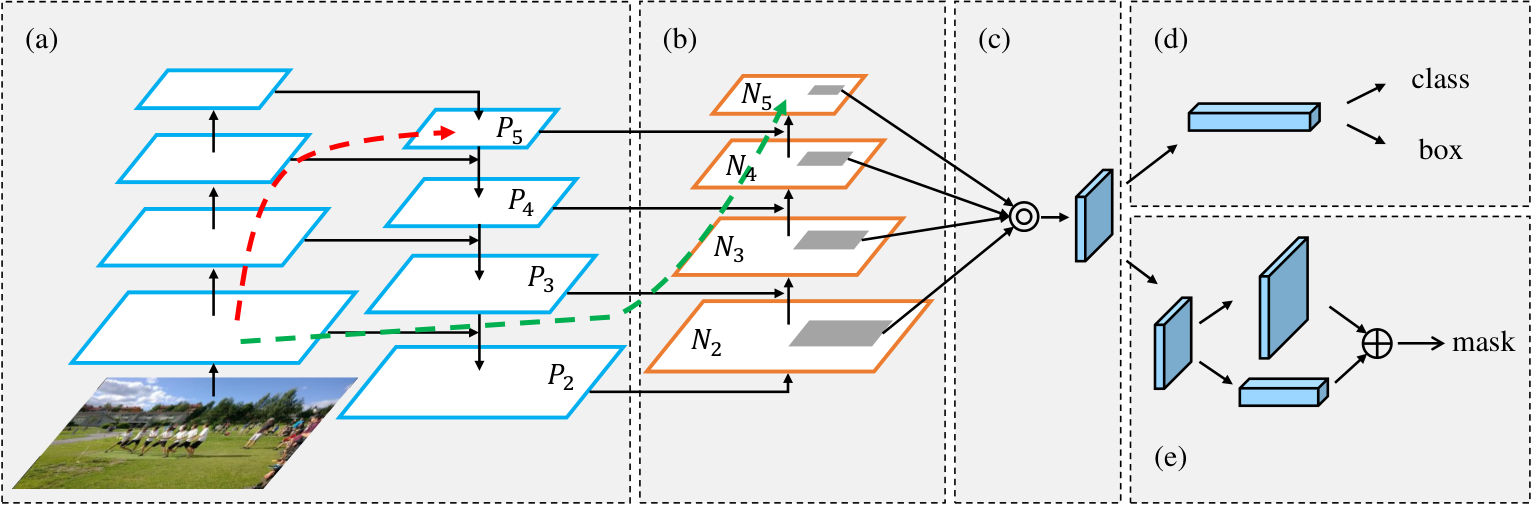
FPN 已经把高层语义送到低层,但底层的边缘、轮廓和精确定位信号要沿卷积主干传播到高层,路径可能很长。PANet 在 FPN 的基础上,从 P2 开始再构造一条自底向上的增强路径:
N2 = P2
N3 = Conv3×3(stride=2)(N2) + P3
N4 = Conv3×3(stride=2)(N3) + P4
N5 = Conv3×3(stride=2)(N4) + P5
每次下采样后与对应的 FPN 特征融合,再用卷积得到下一层。这样,低层的定位信号可以通过更短的路径到达高层,形成比单向 FPN 更充分的双向信息流。
自适应特征池化
在传统 FPN 中,一个候选框通常按大小被分配到某个特征层。PANet 认为,这种硬分配可能过于武断:小候选框也许需要高层上下文,大候选框也可能需要低层的细节。
因此,PANet 对每个候选区域从多个特征层进行 RoIAlign,再用逐元素 max 或 sum 等方式融合,交给后续的分类、框回归或掩码分支。它不是把所有层的整张特征图简单拼接,而是围绕每个 proposal 取出对应区域。
PANet 原论文还加入了用于掩码预测的全连接融合分支。也就是说,今天常说的“PANet”有时只指检测器里的路径聚合 neck,有时指原论文完整的实例分割框架,阅读实现时要看上下文。
原论文报告 PANet 在 COCO 2017 实例分割挑战中取得第一名,并在 MVD、Cityscapes 等数据集上取得当时的领先结果。这是论文当时的竞赛背景,不应直接理解成 PANet 在今天所有检测器中都必然优于其他 neck。
三、BiFPN:让每条融合边学会分配权重
BiFPN 的全称是 Bidirectional Feature Pyramid Network,即双向特征金字塔网络。Mingxing Tan、Ruoming Pang 和 Quoc V. Le 在 EfficientDet: Scalable and Efficient Object Detection 中提出该结构,论文发表于 CVPR 2020。
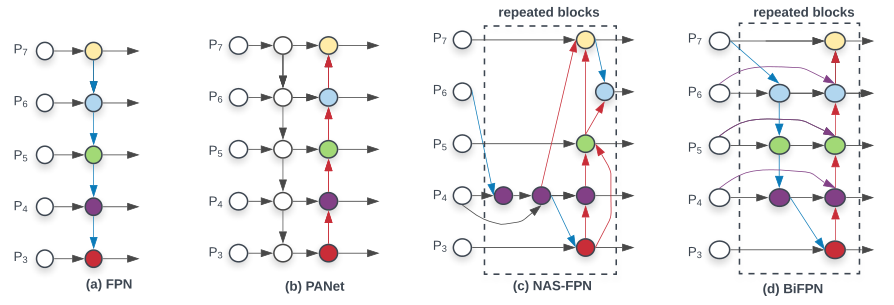
PANet 已经有自顶向下和自底向上的路径,但不同输入在融合时通常还是简单相加。高分辨率特征、低分辨率特征和跨层特征的贡献并不一定相同,BiFPN 因此同时改了连接拓扑与融合方式。
加权融合怎么计算
对于同一融合节点的输入 I₁、I₂、…,BiFPN 不再固定使用等权相加,而是学习非负权重 wᵢ,并做归一化:
O = Σᵢ [ wᵢ / (ε + Σⱼ wⱼ) ] · Iᵢ工程实现里常见做法是先对 wᵢ 使用 ReLU,避免负权重,再用一个很小的 ε 保证数值稳定。这样网络可以根据训练目标决定某个节点更依赖哪一级特征。
BiFPN 还做了三件事:删除只有一个输入、没有融合意义的节点;为同层输入和输出增加额外连接;在 EfficientDet 中重复堆叠 BiFPN,并通过 compound scaling 同时调整骨干、特征网络、预测头和输入分辨率。
不要把论文数字脱离配置
EfficientDet 是一个完整检测器,BiFPN 只是其中的 feature network。原论文在 COCO 单模型、单尺度设置下报告了不同 D0–D7 配置的精度、参数量和 FLOPs;这些数字与 EfficientNet 骨干、输入分辨率、BiFPN 重复次数和预测头共同相关。
因此,“52M 参数、51.0 AP”只能作为原论文特定 EfficientDet 配置的结果,不能写成 BiFPN 单模块的通用性能,也不能据此推断所有 YOLO neck 都会获得相同的速度或精度收益。
四、ASPP:在同一层用不同感受野看上下文
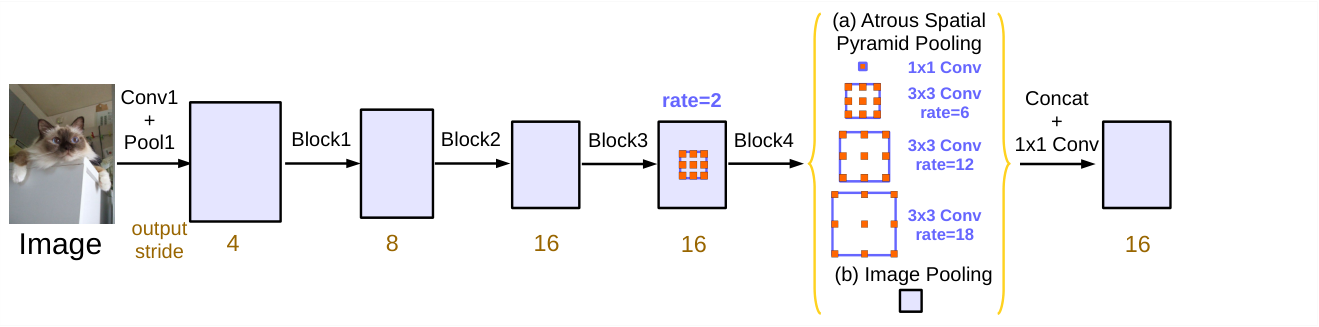
ASPP 的全称是 Atrous Spatial Pyramid Pooling,即空洞空间金字塔池化。它与 FPN、PANet、BiFPN 的核心差异是:ASPP 通常不负责在不同 backbone 层之间传递特征,而是在同一张特征图上用不同膨胀率获取多尺度上下文。
ASPP 出现在 DeepLab 系列中;DeepLabv3 的 Rethinking Atrous Convolution for Semantic Image Segmentation 系统讨论了多分支空洞卷积和图像级特征。把它简单说成“2018 年才提出”并不准确:应区分早期 DeepLab 中的 ASPP 与 DeepLabv3 对该模块的扩展。
空洞卷积的作用
普通 3×3 卷积只看紧邻位置。膨胀率为 r 的 3×3 空洞卷积在核元素之间插入间隔,让感受野扩大,同时不必像普通池化那样继续降低特征图分辨率。
ASPP 常见结构包含:
- 一个 1×1 卷积分支;
- 多个不同膨胀率的 3×3 空洞卷积分支;
- DeepLabv3 中的 image pooling 分支,用全局平均池化提取图像级上下文,再上采样回特征图大小;
- 将各分支拼接,再用 1×1 卷积混合。
DeepLabv3 在 output stride 为 16 时常用 rate=6、12、18;换成 output stride=8 时,常见设置会相应放大为 12、24、36。膨胀率不是脱离特征图分辨率固定不变的“魔法数字”。
ASPP 的优势是以并行分支覆盖多个上下文范围,适合语义分割中“这个像素属于哪一类”的判断;它的代价是多分支计算,以及在高膨胀率下可能出现采样稀疏、局部细节不足的问题。
五、Non-local:让任意位置直接互相参考
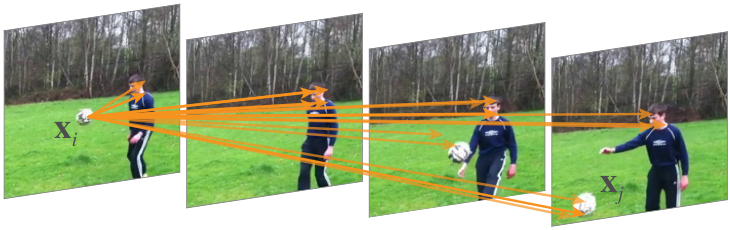
Non-local Neural Networks,即非局部神经网络,由 Xiaolong Wang、Ross Girshick、Abhinav Gupta 和何恺明提出,论文发表于 CVPR 2018。原论文
卷积在一个局部窗口内计算;即使堆叠很多层,远距离位置之间也要经过逐层传递才能建立关系。Non-local 操作则直接让位置 i 汇总所有位置 j 的特征:
yᵢ = 1 / C(x) · Σⱼ f(xᵢ, xⱼ) · g(xⱼ)
zᵢ = W_z(yᵢ) + xᵢ
其中 f 衡量位置 i 与 j 的关系,g 变换被聚合的特征,C(x) 负责归一化,最后通过残差连接回到原始特征。常见实现会用 θ、φ、g 三个 1×1 卷积分支近似这些映射,并用 softmax 归一化相似度。
它和自注意力是什么关系
Non-local 的“对所有位置计算关系并加权求和”与自注意力在形式上高度相似,都是内容相关的全局聚合;但不能简单把二者说成完全相同的模块。Non-local 论文提供了多种关系函数,常见视频实现还会对被聚合的空间或时间维度做下采样;Transformer 则通常围绕 Q、K、V、位置表示和多层注意力 block 组织。
Non-local 最直观的应用是视频:同一个人在不同帧中位置发生变化,某一帧的特征可以直接参考其他帧的相似位置。它也可以插入静态图像的检测、分割和姿态估计网络。
全局连接的代价
如果特征图上有 N 个位置,朴素的两两关系矩阵通常带来 O(N²) 的空间或计算开销;视频中 N 还可能包含 T×H×W。因而 Non-local 不适合不加约束地放在高分辨率特征上。窗口注意力、稀疏注意力、低秩近似或先下采样,都是降低成本的工程方向。
它的价值也不是“全局越多越好”。如果任务只需要局部纹理,ASPP 或普通卷积可能已经足够;只有当远距离依赖确实有用时,全局交互才值得付出代价。
六、把五种方法放在同一张地图上
可以用三个问题快速区分它们:
- 是在不同层之间融合,还是在同一层扩大视野? FPN、PANet、BiFPN 处理特征层之间的尺度关系;ASPP 在同一层并行构造不同感受野。
- 融合权重是固定的,还是由数据学习? FPN 的基础融合是对齐后相加;BiFPN 进一步学习输入边的权重;Non-local 的权重则随位置内容动态变化。
- 是否允许任意位置直接交互? 金字塔和空洞卷积仍然主要沿局部结构传播;Non-local 显式建立全局两两关系,代价也更高。
| 需求 | 优先考虑 | 主要检查点 |
|---|---|---|
| 检测大小差异很大的目标 | FPN 或 BiFPN | 各层 stride、目标分配、显存与吞吐 |
| 需要更短的低层到高层路径 | PANet 或其他双向 neck | 下采样融合是否引入定位偏差 |
| 语义分割需要多尺度上下文 | ASPP | output stride、膨胀率、边界细节 |
| 视频或图像存在远距离依赖 | Non-local 或注意力模块 | N² 成本、位置下采样、实际收益 |
| 想复用成熟检测器结构 | FPN 作为起点 | 先固定骨干和预测头再做对照 |
这五种模块也不是互斥的。一个系统可以用 FPN 提供多层特征,在最高层加入 ASPP;也可以在某个分支中加入 Non-local。比较模块时,应固定 backbone、输入分辨率、训练策略和预测头,只改变融合部分,否则很难判断收益来自哪里。
七、实操时别只看 mAP 或 mIoU
特征融合模块经常同时影响精度、显存和延迟。建议至少记录:
- 小、中、大目标分别的 AP,或分割边界与区域指标;
- 输入分辨率、特征层 stride、batch size、精度格式和硬件;
- 参数量、FLOPs、峰值显存,以及真实端到端延迟;
- 训练和推理时是否启用了多尺度增强、测试时翻转或额外后处理。
一个常见误区是把 FLOPs 降低直接等同于速度提升。BiFPN 的加权融合、ASPP 的多分支、Non-local 的相似度矩阵,都可能受内存访问、算子融合和硬件 kernel 支持影响。部署时要用目标设备实测,而不是只看论文表格。
最后可以这样记:FPN 把高层语义送回低层,PANet 再把低层定位送回高层,BiFPN 让路径权重可学习,ASPP 在同一层用多种感受野看上下文,Non-local 让远处位置直接互相参考。它们共同说明了一件事:特征融合不是简单地“堆更多特征”,而是要决定信息从哪里来、沿哪条路径传播,以及每条信息在当前任务里应该占多大比重。