像 GPT-4 这种动不动几百 B 参数的大模型,“参数量”到底是怎么数出来的?当然不是有人拿着计算器把数字一个个加起来,而是根据每个权重矩阵的形状,把参数数量拆开计算。
这篇文章用一条主线把 CNN、Transformer、ViT 和两种参数高效微调方法串起来。先记住最重要的一句话:
一个权重矩阵有多少个元素,就有多少个参数;模型的参数量就是所有可学习矩阵、向量和标量的元素总数。
一、参数量到底是什么?
假设一个权重矩阵 的形状是 ,它就包含 个参数;一个长度为 的偏置向量 ,就包含 个参数。把模型里所有需要学习的数字相加,就是参数量。
通常我们用下面的单位表示:
- K(千): 个参数;
- M(百万): 个参数;
- B(十亿): 个参数。
参数量首先决定权重本身要占多少存储空间。只看模型权重时,FP32 每个参数约占 4 字节,FP16 或 BF16 每个参数约占 2 字节,所以一个 7B 模型在 FP16 下仅权重就大约需要:
训练显存不能只用这个数字乘一个固定倍数:还要考虑梯度、优化器状态、混合精度下的 FP32 master weight、激活值和临时缓存。以 Adam 全量训练为例,优化器状态本身就可能比 FP16 权重大很多,实际显存还会随着 batch size、序列长度和检查点策略变化。
二、先看一张总览
| 结构 | 参数量主要来自哪里 | 输入分辨率或序列长度会不会直接增加参数 |
|---|---|---|
| 标准卷积 | 卷积核、输入输出通道 | 通常不会;但计算量会增加 |
| 全连接层 | 输入维度 × 输出维度 | 会,只要展平后的输入维度变化 |
| Transformer | Q/K/V/O 投影、前馈网络、词表嵌入 | 序列长度通常不增加参数,但会增加计算量和激活显存 |
| ViT | patch embedding、位置编码、Transformer 编码器 | patch 数变化时,绝对位置编码可能需要插值或重新学习 |
| LoRA | 低秩矩阵 A、B | 取决于注入了哪些权重矩阵 |
| Adapter | 每层插入的瓶颈 MLP | 取决于插入层数和瓶颈维度 |
这张表里有一个很容易被忽略的区别:参数量决定模型有多大,计算量还要看输入有多大。一层卷积的参数量与图片分辨率无关,但分辨率翻倍后,特征图上的位置数量可能变成原来的四倍。
三、CNN:卷积层和全连接层怎么数?
1. 标准卷积
假设卷积核大小是 ,输入通道数是 ,输出通道数是 ,那么卷积核参数量是:
如果卷积层带偏置,还要再加上 :
为什么要乘以输入通道数?
因为一个输出通道需要同时读取所有输入通道的信息。以 RGB 图片为例,输入有 3 个通道;如果卷积核大小是 ,要生成 1 个输出通道,就需要为 R、G、B 三个通道各准备一个 卷积核:
计算时,三个通道分别做卷积,再把结果相加:
所以, 表示每个输出通道要处理多少组输入通道卷积核; 则表示要生成多少个输出特征图,每个输出通道都有自己独立的一套卷积核。例如 、输入 3 通道、输出 64 通道的卷积层,参数量为:
如果带偏置,再加上 64 个参数。
注意,这里数的是可学习参数,不是输出特征图里的数字个数。输入图片从 变成 ,不会让这层卷积核突然变大。
2. 全连接层
全连接层的公式更直接。输入维度为 ,输出维度为 :
卷积网络早期经常在最后接一个很大的全连接层,因此参数大头不一定来自卷积。比如一个 的特征图接到 4096 维全连接层:
而一个输入通道 512、输出通道 4096 的 卷积层只有:
所以全连接层大约是卷积层的 5.4 倍。现代 CNN 常用全局平均池化、瓶颈层和深度可分离卷积,正是在减少这种参数和计算负担。
3. LeNet-5:一个手算例子
LeNet-5 是 Yann LeCun 等人在 1998 年提出的经典手写数字识别网络。第一层卷积的输入是 1 个通道,使用 6 个 卷积核:
如果把第二层卷积近似看成完全连接的卷积,输入 6 个通道、输出 16 个通道:
但要注意,原版 LeNet-5 的第二卷积层采用了部分连接,而不是完整的 6 到 16 通道全连接,所以原论文的实际计数会低于这个简化公式。教材里常见的 2416,是按标准全连接卷积公式估算出来的数字。
后面的第一个全连接层输入 400 维、输出 120 维:
整个 LeNet-5 只有约 6 万个参数。和今天的十亿级模型相比,它更像一个可以放在纸上完整展开的小网络。
4. 深度可分离卷积:MobileNet 的参数压缩
标准 卷积的参数量为:
深度可分离卷积拆成两步:
- Depthwise convolution:每个输入通道单独做卷积,参数量为 ;
- Pointwise convolution:使用 卷积混合通道,参数量为 。
合起来是:
相对于标准卷积,参数比例约为:
当输出通道很多、卷积核又不是 时,压缩效果会很明显。这也是 MobileNet 能在移动端使用较深网络的重要原因之一。
四、Transformer:参数主要藏在注意力和 FFN
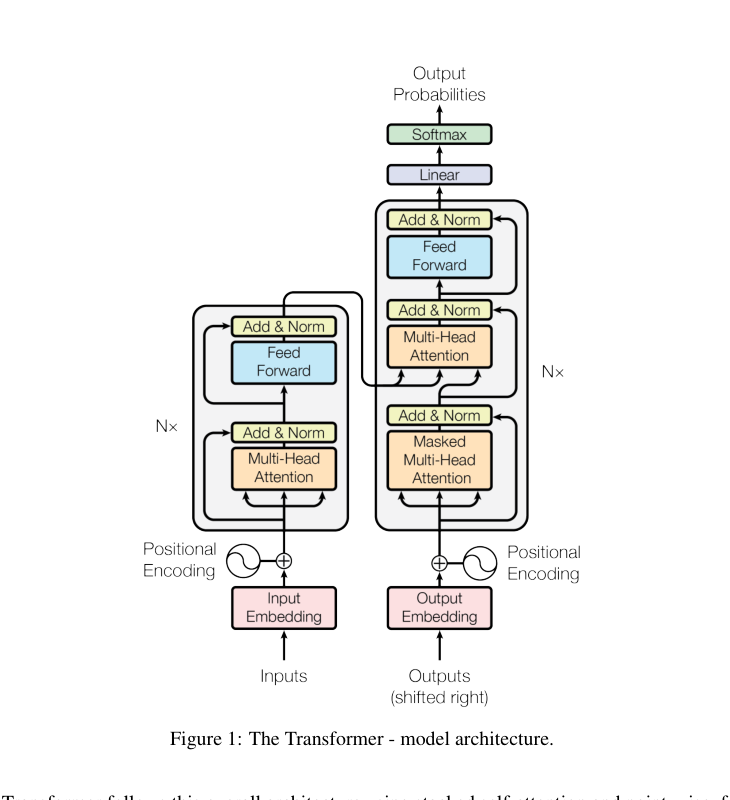
Transformer 的单层通常由多头自注意力、前馈网络、残差连接和归一化组成。真正占参数大头的,通常是前两者。
1. 自注意力部分
设隐藏维度为 。最基础的多头注意力需要四个投影:
- :生成 Query;
- :生成 Key;
- :生成 Value;
- :把多头结果投影回隐藏空间。
如果四个矩阵都是 ,那么参数量约为:
如果实现带有偏置,再额外加上若干个 维向量;和 相比通常很小。
2. 前馈网络 FFN
标准 Transformer FFN 通常先把维度从 扩大到 ,经过激活函数后再投影回来:
如果 ,就是:
因此,一个使用标准 FFN 的 Transformer 层可以粗略估算为:
这就是“每层约 12 倍隐藏维度平方”这个速算口诀的来源。
3. GPT-2 small:为什么不是只乘层数?
GPT-2 small 的典型配置是:
每层注意力参数:
每层 FFN 参数:
每层主体约 7.08M,12 层约 84.9M。除此之外还要加上:
- 词嵌入:约 M;
- 位置嵌入:约 M;
- LayerNorm 和偏置等小项。
所以 GPT-2 small 的总量约为 124M。只把“单层参数 × 层数”当成总参数,会漏掉词表嵌入和位置相关参数。
4. LLaMA-7B:SwiGLU 会改变 FFN 公式
LLaMA 系列使用的是 SwiGLU,而不是只有两层线性变换的标准 FFN。SwiGLU 通常需要三组投影:gate、up 和 down。因此,前馈部分更接近:
而不是 。
以 LLaMA-7B 的典型配置为例:
单层粗略参数量为:
32 层约 6.48B,再加词嵌入、输出投影、归一化和其他小项,就落在约 7B 的量级。
实际模型还可能使用 GQA、不同的词表大小、权重绑定或不同的 FFN 宽度,所以“7B”是四舍五入后的模型规模,不是一个必须精确到个位数的数字。
五、ViT:参数量如何拆成 patch embedding、位置编码和 Transformer?
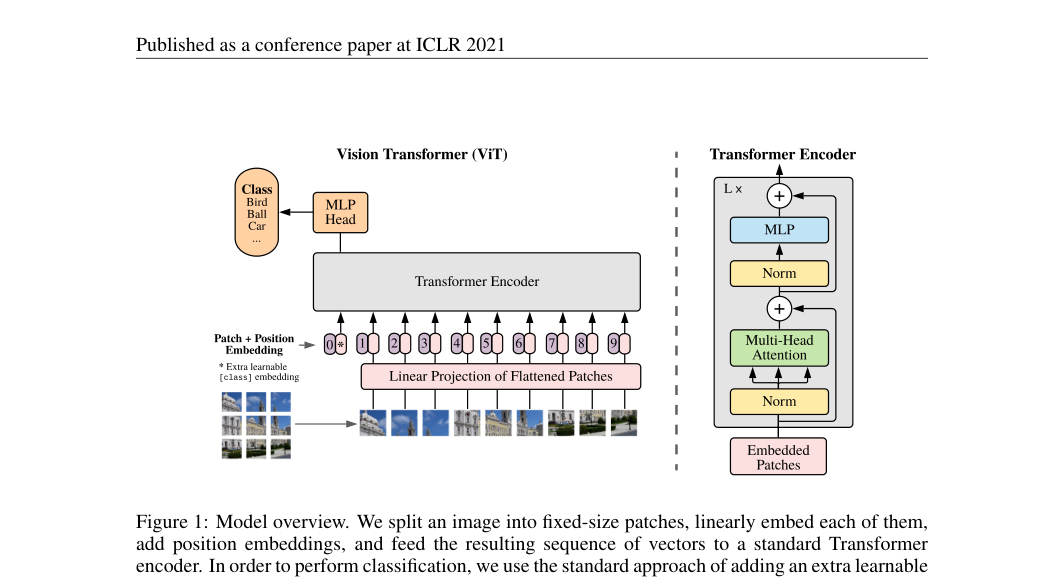
ViT 的思路是把图像切成 patch,再把每个 patch 变成一个 token。假设输入图片大小为 ,patch 大小为 ,输入通道数为 ,隐藏维度为 ,那么 patch 数量是:
1. Patch embedding
每个 patch 展平后维度为 ,再通过一个线性层映射到 维:
如果实现直接使用一个卷积层,卷积核大小为 、步幅为 ,得到的参数量是一样的。
2. 位置编码
如果额外加入一个 CLS token,序列长度就是 。可学习绝对位置编码的参数量为:
它通常并不是 ViT 的参数大头,但当输入分辨率变化时,位置编码的形状也会变化,因此很多实现需要做二维插值。
3. ViT-Base/16:完整估算
ViT-Base/16 的典型配置是:
patch 数量:
Patch embedding:
位置编码:
12 层 Transformer 编码器约为:
再加分类头、LayerNorm 和 CLS token,ViT-Base/16 通常约 86M 参数。由此可以看出,ViT 的参数大头仍然来自 Transformer 编码器,而不是 patch embedding。
六、LoRA:只训练一个低秩更新
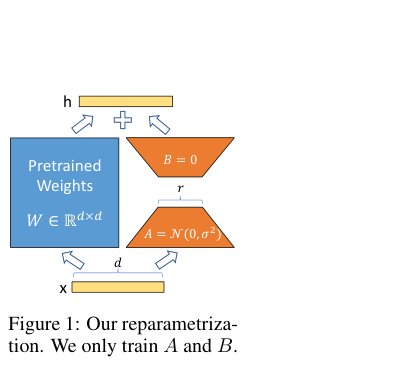
LoRA(Low-Rank Adaptation)的核心是冻结原来的权重矩阵,只训练一个低秩更新:
假设原矩阵 是 ,秩为 :
- 的形状是 ;
- 的形状是 。
因此 LoRA 新增的可训练参数为:
例如:
全量更新一个 矩阵需要:
个参数;LoRA 只需要:
也就是约 0.13M,只有原矩阵参数量的约 0.78%。这还只是一个矩阵,最终可训练参数量要看 LoRA 注入了哪些层:只注入 Q、V,和注入 Q、K、V、O,结果会不同。
LoRA 的另一个优点是,训练完成后可以把 合并回 ,推理时不一定需要额外的分支,因此通常不会像显式外挂模块那样增加推理延迟。
七、Adapter:每层插入一个瓶颈 MLP
Adapter 的思路不是改写原矩阵,而是在 Transformer 层中插入一个小型瓶颈模块:
设输入输出维度为 ,瓶颈维度为 ,忽略偏置时,一个 Adapter 的参数量是:
如果每个 Transformer 层插入两个 Adapter,那么 层的总量约为:
例如 、、:
是一个 Adapter 的参数量;每层两个、共 12 层:
Adapter 很适合多任务场景:所有任务共享冻结的底座模型,每个任务只保存一份很小的 Adapter 参数。不同实现可能改变 Adapter 的插入位置、是否加入 LayerNorm、瓶颈激活函数和缩放,因此实际数字会有小幅差异。
八、五种方法放在一起怎么选?
| 方法 | 典型参数公式 | 参数量的主要控制旋钮 | 适合解决的问题 |
|---|---|---|---|
| 标准卷积 | 卷积核、通道数 | 视觉特征提取 | |
| 深度可分离卷积 | 分组方式、通道数 | 移动端降参降算力 | |
| Transformer 层 | 隐藏维度、FFN 宽度、层数 | 语言和序列建模 | |
| ViT | patch embedding + 位置编码 + Transformer | patch 大小、隐藏维度、层数 | 图像 token 化与视觉建模 |
| LoRA | 秩 、注入的矩阵数量 | 低显存参数高效微调 | |
| Adapter | 约 或其倍数 | 瓶颈维度、层数、模块数量 | 多任务和模块化适配 |
最后再强调三个容易混淆的点:
- 参数量不等于计算量。 Transformer 参数量可能不随序列长度增加,但注意力计算量通常随序列长度平方增长。
- 不同模型的 FFN 结构不能套同一个公式。 标准 FFN 常见两矩阵,SwiGLU 则通常需要三矩阵;MoE 还要区分总参数和每次前向实际激活的参数。
- 微调参数量不等于底座模型参数量。 LoRA 和 Adapter 只减少需要更新、保存和通信的参数,不会让被冻结的底座权重凭空消失。
掌握这些公式以后,拿到一个新模型,先看它的矩阵形状、重复层数、词表大小和注入位置,就能快速估出大致规模;再根据实现里的 bias、归一化、权重共享、GQA、SwiGLU 或 MoE 做细化修正。
参考资料
- LeNet-5:Gradient-Based Learning Applied to Document Recognition
- MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications
- Attention Is All You Need
- An Image Is Worth 16x16 Words: Transformers for Image Recognition at Scale
- LLaMA: Open and Efficient Foundation Language Models
- LoRA: Low-Rank Adaptation of Large Language Models
- Parameter-Efficient Transfer Learning for NLP